Advanced RAG 実践ガイド ― Naive RAG の次へ、失敗原因から設計する検索拡張生成
206 Views
November 14, 26
スライド概要
Naive RAG を理解し始めた技術者が、Advanced RAG の導入プロジェクトをリードできる水準まで理解を引き上げるための解説資料です(96 枚)。Advanced RAG を「失敗原因 → 対策」の対応で整理し、取込・チャンク・ハイブリッド検索・再ランキング・クエリ変換・GraphRAG・Agentic RAG・評価・安全と運用・テックリーダーの実務までを扱います。
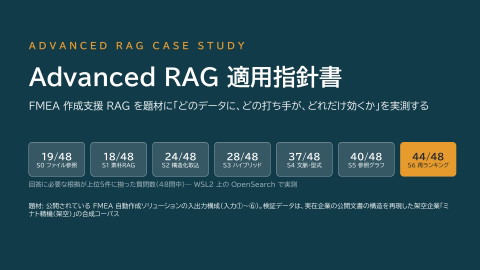
実践編(FMEA 作成支援を題材にした実測):https://www.docswell.com/s/takenori_kusaka/59NPMW-advanced-rag-fmea-casestudy
Web スライド:https://takenori-kusaka.github.io/advanced-rag-fmea-casestudy/guide/
ライセンス:CC BY 4.0。本資料は生成AI(Claude)を使って作成し、筆者が確認して公開しています。
IoT・クラウド・生成AIエンジニア。製造業の現場からクラウド、生成AIまでを横断して15年。組込み開発、無線機器、クラウド基盤の標準化とガバナンス、生成AIの業務実装に携わってきました。現場の課題を選択肢・コスト・影響範囲として示し、意思決定を前進させる設計を専門としています。 スライドは Advanced RAG、AI協調型の開発プロセス(ピットイン方式)、製造業DXなど。 Zenn: https://zenn.dev/takenori_kusaka 発信は個人の見解であり、所属組織の公式見解ではありません。
関連スライド

各ページのテキスト
ADVANCED RAG Advanced RAG 実践ガイド Naive RAG の次へ ― 失敗原因から設計する検索拡張生成 取込 検索 順位付け 生成 評価 運用・安全 対象: Naive RAG を理解し始めた技術者 / Advanced RAG 導入プロジェクトの新任テックリーダー 原典「Advanced RAG技術レポート」(調査基準日 2026-11-13)を再構成し、基礎解説・リーダー実務を補足
この資料のゴールと読み方 「どの手法が最強か」ではなく「どの失敗に、何が、どの条件で効くか」を説明できる状態を目指す 理解のゴール • RAGの失敗を段階別に診断できる • 主要手法の仕組み・効く条件・コストを 説明できる • 論文やベンダーの数字を正しく読める リーダーとしてのゴール • 評価基盤を先に作り、改善を実測で判 断できる • 採用・不採用を根拠付きで合意形成で きる • 権限・鮮度・コストのリスクを先回りで きる この資料の使い方 • 本文スライド=要点、ノート欄=詳しい 解説 • 各Partは前のPartの用語を前提に進 む • 付録に用語集と出典一覧を収録 凡例 検索 上部のステージ表示:その話題がRAGパイプラインのどこに関 わるか 補足:元レポート外の一般知識による解説(確度は出典ごとに確認) Advanced RAG 実践ガイド|新任テックリーダー向け リーダーの視点:判断・説明の観点 採用判断:元レポートの推奨する判断 2
全体の構成 基礎 → 全体像 → 手法各論 → 評価 → 安全・運用 → 設計 → リーダー実務 → アンチパターン大全 Part 0 基礎の総点検 Naive RAG・埋め込み・BM25・失敗点 Part 2 手法各論 取込・検索・クエリ・構造・Agentic・学習・長文 Part 4 セキュリティ・運用・費用 権限・汚染・鮮度・コストモデル Part 6 テックリーダーの実践 90日計画・合意形成・アンチパターン集 付録 Part 1 全体像と証拠の読み方 4段階の整理・診断表・指標 Part 3 評価 層別指標・実験手順・評価セット Part 5 参照設計とロードマップ コンポーネント・採用レーダー・導入段階 Part 7 アンチパターン大全 3 層の失敗・規模の罠・全社横断 RAG の事例 用語集・出典 用語の定義と一次資料 Advanced RAG 実践ガイド|新任テックリーダー向け 3
結論を先に:Advanced RAG で押さえるべき5点 基盤(構造保持の取込・権限付きハイブリッド検索・再ランキング・原文引用・評価)が先、高度化は後 検索品質の基盤 Dense 単独を標準解にしない。BM25等との補完+再ランキングを評価。ただし再ランキングが 性能を下げる領域もある(2-B) 文脈欠落への対策 Contextual Retrieval / Late Chunking はチャンク単体で失われる意味を補うが、1 文書の 中を探す検索では不利になる結果もある(2-A) グラフの使い分け コーパス全体の論点把握(コミュニティ要約)と、多段の関連探索(HippoRAG 2 等)は別物。「 GraphRAG」で一括評価しない(2-D) Agentic RAG の本質 検索回数を増やすことではない。検索語・粒度・読取範囲・停止条件をモデルに選ばせ、停止の適切 さも評価する 評価の重心 検索単体の指標に加え、多段検索の途中の各段と、取込から回答までの通し(E2E)を測る。非公開 評価と公開ベンチマークは区別(Part 3) 出典: Huang & Huang (ACM CSUR)、BEIR、BRIGHT、Anthropic Contextual Retrieval、Beyond Chunk-Then-Embed、GraphRAG、HippoRAG 2、A-RAG、 AgenticRAGTracer、MLPerf Advanced RAG 実践ガイド|新任テックリーダー向け 4
中心原則:手法のランキングではなく「失敗原因 → 対策」の対応 最も高度な方式を選ぶのではなく、実測した失敗原因に対して最小限の追加機構を選ぶ よくある誤解の進め方 Advanced RAG の正しい進め方 • 「最新手法トップ10」から強そうなものを選ぶ • 評価セットとベースラインを先に作る • GraphRAG・Agent・圧縮を全部重ねる • 失敗を「根拠不在/検索失敗/利用失敗」に分類 • 論文の改善率を足し算して効果を見積もる • 原因に効く最小の追加機構を1つずつ試す • 平均スコアだけを見て採用を決める • 同一条件で層別に測り、コストと新たな故障も確 認 リーダーの視点 「どの手法を入れるか」ではなく「どの失敗を、どれだけ減らすか」でロードマップを語る 出典: 元レポート「エグゼクティブサマリー」「総括」 Advanced RAG 実践ガイド|新任テックリーダー向け 5
PART 0 基礎の総点検 このPartで答えられるようになる問い • RAG はなぜ必要で、何を解決するのか? • 埋め込み・ベクトル検索・BM25 はそれぞれ何をし ているのか? • Naive RAG はどこで、どのように失敗するのか? • 「精度が悪い」をどう分解して議論するか? Advanced RAG を学ぶ前に、Naive RAG の構成要素と「 どこで壊れるか」を正確に押さえる 6
補足 取込 検索 順位付け 生成 評価 運用・安全 RAG とは何か:なぜ LLM に検索を足すのか RAG = 質問に関係する文書を検索し、その原文を根拠として LLM に回答させる構成 鮮度 LLM 単体の限界:学習時点 以降の情報を持たない → 最 新文書を検索して渡す 社内知識 根拠の提示 LLM 単体の限界:非公開の 規程・設計書を知らない → 社内コーパスを検索 LLM 単体の限界:どこに書い てあるかを示せない → 原文 に紐づく引用 権限 LLM 単体の限界:利用者ご とに見せてよい情報が違う → 検索境界で制御 ポイント 質問 検索 文脈構成 生成 関連文書を探す 原文をプロンプトへ 根拠付きで回答 Advanced RAG 実践ガイド|新任テックリーダー向け RAG は LLM を賢くする技術で はなく、正しい根拠を渡す技術 7
補足 取込 検索 順位付け 生成 評価 運用・安全 Naive RAG の基本パイプライン 索引フェーズ(事前)と質問フェーズ(実行時)に分かれる。Advanced RAG はこの各箱を改良する 索引フェーズ(事前処理) 文書 テキスト化 チャンク分割 埋め込み ベクトルDB PDF・Wiki・規程 OCR・抽出 例: 数百トークン単位 テキスト→ベクトル 索引として保存 質問の埋め込み 近傍検索 プロンプト構成 LLM 生成 同じモデルでベクトル化 類似度上位 k 件 上位チャンクを連結 回答を出力 質問フェーズ(実行時) 質問 ポイント Naive RAG の弱点:①構造を捨てたテキスト化 ②固定長分割で文脈が切れる ③ベクトル類似度だけで選ぶ ④上位 k 件をそのまま詰める ⑤根拠の検証・棄権がない Advanced RAG 実践ガイド|新任テックリーダー向け 8
補足 取込 検索 順位付け 生成 評価 運用・安全 埋め込み(Embedding)とベクトル類似度 意味の近い文ほど近い位置に来るよう、文を数百〜千次元のベクトルに写像する 質問「有給休暇の繰越上限は?」 エンコーダ q = [0.12, −0.48, …] cos(q, d) = 0.87 q·d / (|q||d|) 1 に近いほど意味が近い チャンク「年次休暇は最大20日まで翌年 度へ…」 エンコーダ 得意 言い換え・同義表現(「有給」と「年次休暇」)、文意の近さ。文書側ベクト ルを事前計算できるので大規模でも高速(バイエンコーダ) Advanced RAG 実践ガイド|新任テックリーダー向け d = [0.10, −0.51, …] 苦手 型番・品番・条項番号など文字列一致が重要な検索、学習領域外の専門 語、質問と文書の細かな対応関係(1本のベクトルに圧縮されるため) 9
補足 取込 検索 順位付け 生成 評価 運用・安全 近似最近傍探索(ANN)とベクトル DB の勘所 数百万件を全件比較せず「だいたい最も近い」候補を高速に返す。速度と再現率はトレードオフ HNSW 近いベクトル同士をつないだ多層グラフを 上層から辿る。高速・高再現率だがメモリ消 費が大きい IVF・量子化 ベクトル空間をクラスタに分け、近いクラス タだけ探す。量子化(PQ等)で容量を削減す るが精度は低下し得る 調整パラメータ 探索幅(ef・nprobe 等)を上げると再現率 ↑・遅延↑。「ANN の取りこぼし」は Recall 低下として現れる 注意 権限フィルタの落とし穴:上位 k 件を取ってから ACL で絞る「ポストフィルタ」は、権限のある文書が候補から消え件数不足や利用 者間の品質差を生む。ACL・版・有効日はメタデータ条件として検索時に組み込む(Part 4 参照) 検証観点:再現率(厳密検索との一致率)/p95 遅延/索引サイズ/更新・削除の反映時間/フィルタ併用時の性能 Advanced RAG 実践ガイド|新任テックリーダー向け 10
補足 取込 検索 順位付け 生成 評価 運用・安全 BM25(語彙検索):古いが強いベースライン 「質問の単語が、その文書で何回・どれだけ珍しく出るか」で順位付けする。型番や固有名詞に強い スコアを決める3要素 日本語での注意点 TF(単語頻度) その文書に質問語が多く出るほど高い。ただ し頻度が増えるほど効果は飽和する • 単語分割が必須:形態素解析(Sudachi・MeCab 等)か文字 n-gram。辞書にない社内用語・型番の分割を確認 • 表記ゆれ正規化:全角/半角、長音、カタカナ/英字、略称 IDF(逆文書頻度) コーパス全体で珍しい語ほど重い。「の」「規程 」より「XJ-4021」が効く 文書長の正規化 長い文書が単語を多く含むだけで有利になら ないよう補正する • 同義語:辞書で補うか Dense 検索と併用 ポイント BM25 は「意味」を理解しないが、文字列一致が重要な企業文書(型番・条項番号・製品名・人名)で Dense の弱点を補う。だからハ イブリッドが基本になる 出典: BEIR(BM25 は強いゼロショットのベースライン) Advanced RAG 実践ガイド|新任テックリーダー向け 11
補足 取込 検索 順位付け 生成 評価 運用・安全 Naive RAG はどこで壊れるか:7つの失敗点 3つの実案件から抽出された失敗点。3つは生成より前の段階で、生成段の失敗も文脈の質が原因のことが多い FP1 FP2 FP3 FP4 FP5 FP6 FP7 内容の欠落 上位を逃す 文脈に入らな い 抽出できない 形式の誤り 具体性の不一 致 不完全な回答 コーパスに答えが ない 正解文書が topk外 統合段階で切り 落とし ノイズに埋もれ読 めない 表・リスト等の指 定違反 粗すぎ/細かす ぎ 一部の根拠しか 使わない 取込 検索 順位付け 生成 生成 生成 生成 リーダーの視点 論文の教訓:RAG の検証は運用中にしか十分にできず、堅牢性は運用で育つ。→ 失敗を段階別に観測できるログと評価基盤を初日 から用意する 出典: Barnett et al., "Seven Failure Points When Engineering a RAG System", CAIN 2024(arXiv:2401.05856) Advanced RAG 実践ガイド|新任テックリーダー向け 12
取込 検索 順位付け 生成 評価 運用・安全 「精度が悪い」を分解する:3つの根本原因 切り分け順:①正解は索引にあるか ②候補に入ったか ③正解文書を直接渡せば答えられるか(Oracle Context) 根拠不在 検索失敗 利用失敗 答えが索引にない 索引にあるが取れない 取れたのに使えない • 原本にない(棄権が正解) • 候補に入らない(Recall) • 読解・計算の誤り • 取込で表・注記が欠落 • 候補の下位に沈む(順位) • 引用が主張と不一致 • 権限・版で対象外(棄権が正解) • 多段で辿れない • 文脈ノイズで抽出失敗 主な打ち手 主な打ち手 主な打ち手 取込改善・データ整備・正しく棄権 ハイブリッド・再ランキング・質問分解 文脈構成・計算ツール・検証・モデル比 較 出典: 元レポート「全体像:失敗箇所から手法を選ぶ」 Advanced RAG 実践ガイド|新任テックリーダー向け 13
PART 1 全体像と証拠の読み方 このPartで答えられるようになる問い • Advanced RAG は何を改善する手法群か? • 症状からどこを疑い、何を試すか? • 論文・ベンダーの数字をどう読むべきか? • Recall・nDCG・EM・F1 は何を測っているか? Advanced RAG を「段階」と「失敗」の地図として捉え、論 文の数字を誤読しない読み方を身につける 14
取込 検索 順位付け 生成 評価 運用・安全 Advanced RAG の定義:段階ごとの改善手法群 特定の製品や単一アルゴリズムではない。「質問を埋め込み上位チャンクを渡す」構成を各段階で改善する手法の総称 検索前 検索 検索後 生成 Pre-retrieval Retrieval Post-retrieval Generation • 構造保持の取込 • BM25+Dense ハイブリッド • 再ランキング • 引用付き生成 • チャンク設計・親子 • RRF による融合 • 重複除去・多様性 • 主張・引用の検証 • Contextual / Late Chunking • Multi-vector / ColBERT • 親チャンク拡張 • 計算ツール分離 • グラフ・階層索引 • コンテキスト圧縮 • 棄権・回答範囲限定 • クエリ書換・HyDE・分解 推論制御(Agentic):検索語・粒度・読取範囲・停止条件をモデルが選ぶ / 学習:RAFT・Search-R1 横断:評価 / 監査 / コスト / 削除反映 / 攻撃耐性 / 観測性 出典: Huang & Huang, ACM Computing Surveys(検索前・検索・検索後・生成の4段階整理)、A-RAG(推論中の検索制御) Advanced RAG 実践ガイド|新任テックリーダー向け 15
取込 検索 順位付け 生成 評価 運用・安全 参照処理フロー①:取り込み側 原文・権限・版を起点に、検索用の複数の索引を派生させる。全経路の実装は不要、必要な分岐だけ足す 原本・権限(ACL)・版・有効日 設計の鍵 • 派生データはすべて原本の 版・ACL に紐づける レイアウト解析 / OCR / ページ画像 / 表・コ ード構造 語彙索引 / Sparse 索引 • 検索用表現と引用原文を分 離 • 索引は交換可能に 原文チャンク+親文書+文・ページ位置 Dense / Multi-vector 索引 任意:階層要約 / エンティティ・関係グラフ リーダーの視点 取込は「地味な前処理」ではなく品質と安全の起点。ここで落ちた情報は、後段のどんな高度化でも取り戻せない 出典: 元レポート「処理レイヤーの対応関係」(本レポート独自の整理・設計モデル) Advanced RAG 実践ガイド|新任テックリーダー向け 16
取込 検索 順位付け 生成 評価 運用・安全 参照処理フロー②:質問側 権限と時点を確定してから検索し、証拠が足りるかを判定してから答える。足りなければ再検索か棄権 認証・権限・時点・タスク分類(単純/多段) Naive RAG との違い • 検索前に権限・時点を確定(後付けしない) 通常検索 / 質問分解 / Agentic ループ • 取得結果をそのまま詰めず、統合・再順位・拡張 • 「答えられるか」を判定し、不足なら再検索か棄権 • 生成後に主張と引用の整合を検証 候補統合 → 再ランキング → 原文拡張 → 重複除去 証拠選択・充足判定 不足 → 2 段目に戻り再検索 / 別データ源 / 棄権 充足 → 引用付き生成 → 主張・引用検証 → 回答 出典: 元レポート「処理レイヤーの対応関係」 Advanced RAG 実践ガイド|新任テックリーダー向け 17
取込 検索 順位付け 生成 評価 運用・安全 診断表:症状 → 疑う箇所 → 優先的に試す手段 観測された失敗から逆算して手法を選ぶ。この表は「診断の仮説」であり、検証して確定させる 観測される失敗 先に疑う箇所 優先的に試す手段 原本の表・注記が索引にない 文書取り込み レイアウト解析、表の構造保持、ページ画像検索 型番や契約条項を探せない 候補検索 BM25・Sparse 併用、メタデータ条件 文書はあるが主語・時点が不明 表現・粒度 見出し付加、親子検索、Contextual Retrieval 必要文書が候補内の下位にある 順位付け 領域に合う再ランキング、学習負例の改善 文書 A から文書 B へ辿れない 探索 質問分解、グラフ探索、Agentic RAG 根拠を渡しても誤答する 読解・計算・生成 原文配置改善、計算ツール、回答モデル比較、RAFT 回答は正しそうだが引用が違う 主張と証拠の整合 ALCE 型の引用評価、文単位の証拠照合 更新前や権限外の内容が出る 検索境界・派生データ管理 版・ACL を含む索引/キャッシュの失効設計 出典: 元レポート「全体像:失敗箇所から手法を選ぶ」 Advanced RAG 実践ガイド|新任テックリーダー向け 18
取込 検索 順位付け 生成 評価 運用・安全 エビデンスの種類:出所で読み方を変える 査読・掲載は有用な品質シグナルだが、自社データでの効果や独立再現性を保証しない 表記 根拠の性質 読み方 学会・論文誌掲載 公式の掲載先を確認できた論文 査読は品質シグナルだが、外的妥当性・独立再現性は保証しない 論文本体 arXiv 等で本文・実験を確認 著者による報告として扱う。掲載先未確認でも未査読と断定しない 開発元評価 企業・開発者による実験 再現条件、データ公開、分布上の有利さ、利益相反を点検 公式仕様・実務報告 実装ドキュメント、導入経験 実現方法・運用知見の根拠。性能優位の証明には用いない リーダーの視点 ベンダー提案の「精度◯%向上」は、①誰が測ったか ②どのデータか ③何の指標か ④比較相手は何か ― の4点を必ず確認する 出典: 元レポート「根拠の種類」、Thoughtworks Technology Radar(RAG 項目) Advanced RAG 実践ガイド|新任テックリーダー向け 19
取込 検索 順位付け 生成 評価 運用・安全 数字を比較する際の5原則 同じ「精度」という言葉でも、測っているものが違えば比較できない 1 Recall・nDCG 必要文書が候補に入るか・順位が適切か。回答の正しさそ のものではない 2 EM・F1・正解率 評価条件依存。Contain Accuracy や LLM 判定を厳 密な EM と混同しない 3 LLM 選好勝率 2回答の比較結果であり事実正解率ではない。生成と評価 の両方が LLM なら偏りも疑う 4 5 相対改善とポイント差 実験条件 失敗率 5.7%→1.9% は絶対 −3.8pt・相対 −67%。「 精度67%向上」ではない モデル・コーパス・件数・トークン予算・プロンプト・評価器が 違う値は並べない 例:Contextual Retrieval 5.7% → 1.9% 上位20件の検索失敗率(1−Recall@20) −3.8pt −67% 絶対差 相対減少 ✕ 「回答精度が67%向上」は誤読 検索の失敗率の変化であり、最終回答の正しさを 直接示すものではない 出典: 元レポート「数字を比較する際の原則」、Anthropic Contextual Retrieval Advanced RAG 実践ガイド|新任テックリーダー向け 20
補足 取込 検索 順位付け 生成 評価 運用・安全 指標の基礎①:検索の指標を手で計算してみる 正解文書が2件(D2・D7)の質問で、検索結果の上位5件が下の順だった場合 検索結果(上位5件) 1位 D5 ✕ 2位 D2 3位 D9 ✕ 4位 D7 5位 D1 ✕ 正解 正解 指標 定義(直感) この例の値 Recall@5 正解のうち上位5件に入った割合 2/2 = 1.00 Recall@1 正解のうち1位に入った割合 0/2 = 0.00 Precision@5 上位5件のうち正解の割合 2/5 = 0.40 MRR 最初の正解の順位の逆数(平均) 1/2 = 0.50 nDCG@5 順位で割り引いた利得 ÷ 理想の並びの利得 1.062 / 1.631 ≈ 0.65 DCG = Σ rel_i / log2(i+1) → 0.631 + 0.431 = 1.062、理想の並び(1・2位)= 1 + 0.631 = 1.631 ポイント 候補検索は Recall@k(取りこぼさないか)、再ランキング後は nDCG・MRR(上位に来るか)で 測る。目的が違う段階を同じ指標で評価しない Advanced RAG 実践ガイド|新任テックリーダー向け 21
補足 取込 検索 順位付け 生成 評価 運用・安全 指標の基礎②:回答・引用の指標 「正しく答えた」「正しく引用した」「根拠に忠実だった」は別々に測る 指標 何を測るか 注意点 EM(Exact Match) 正規化後の回答が正解と完全一致 言い換えに厳しい。短答 QA 向き F1(トークン) 回答と正解の単語の重なり 部分点が出る。長文回答には不向き Contain Accuracy 正解文字列が回答に含まれるか EM より緩い。同列に比較しない LLM 判定(LLM-Acc 等) LLM による意味的一致の判定 評価器・プロンプトで値が変わる。人手で較正 LLM 選好勝率 2回答のどちらが良いか 正解率ではない。包括性など観点依存 忠実性(Faithfulness) 回答が渡した根拠に支持されるか 根拠自体が誤りなら忠実でも誤答 引用再現率・適合率 主張が引用で支持されるか・引用が適切か 引用品質と回答の正しさは別に動く 注意(ALCE) ALCE(ASQA、ChatGPT):引用の良い回答を選び直す方式で引用再現率は 73.6→84.8 に上がったが、正確性(EM 再現率)は 40.4→40.2 とほぼ不変。「引用付き=正しい」ではない 出典: ALCE、Ragas、ARES、A-RAG(LLM-Acc)、GraphRAG(LLM 選好勝率) Advanced RAG 実践ガイド|新任テックリーダー向け 22
PART 2 手法各論 このPartで答えられるようになる問い • 取込とチャンクで何が失われ、どう補うか? • ハイブリッド検索と再ランキングはなぜ基本か? • GraphRAG・Agentic RAG はどんな質問に効く のか? • 学習・マルチモーダル・長文はいつ検討するか? パイプラインの上流から順に、各手法の「仕組み・効く条件・限 界・採用判断」を押さえる 23
取込 検索 順位付け 生成 評価 運用・安全 2-A 取込:構造を残すことが高度化の出発点 OCR で文字だけ抜くと、表の行列関係・図とキャプション・段組み・見出し階層が失われる テキスト化で失われるもの 残すべき構造と取込方式 表の行列関係 「どの値がどの行・列か」が消える • レイアウト解析で見出し・段落・表・図を識別 • 表は行列構造(HTML/Markdown 表等)で保持 • 図表主体ならページ画像検索を併用(2-G) 図とキャプション 図中の情報と説明の対応が切れる 段組み 二段組みの文が交互に混ざる • 抽出方式とページ画像検索を用途で使い分ける ポイント(実務の目安は補足) 見出し階層 「第3章 2節の例外規定」が分からない Docling 等の構造化取込ツールは「試す価値がある」段階。 自社の代表文書 20〜50 件で抽出結果を目視確認してから 全量投入する 出典: Scaling Beyond Context(ACL 2026 文書 Multimodal RAG サーベイ)、Thoughtworks Radar: Docling(2026年4月 Trial) Advanced RAG 実践ガイド|新任テックリーダー向け 24
取込 検索 順位付け 生成 評価 運用・安全 2-A 共通メタデータ:原文に戻れる設計にする 本文だけを保存しない。検索用表現と実際に引用する原文を分離し、後段で原文・版・権限に戻れるようにする フィールド 用途 無いと起きること document_id / version どの文書のどの版か 古い版の回答、削除が派生データ に伝播しない page / section_path 引用の表示、章節での絞込み 「どこに書いてあるか」を示せな い 原文オフセット(start/end) 文単位の引用・検証 主張と原文の照合ができない parent_id 親子検索で親チャンクを読む 小さすぎるチャンクで文脈不足 ACL(閲覧権限) 検索前・返却前の権限制御 権限外の情報が回答に混入 有効日(施行・失効) 質問時点に有効な情報を選ぶ 廃止済み規程で回答 Evidence の型(例) sourceId version locator { page, start, end } originalText // 生成した索引用説明や要約は // originalText に混ぜない リーダーの視点 初期スキーマに入れ忘れると、後から全件再取込になる。最初の設計レビューの必須項目にする 出典: 元レポート「構造を残すことを高度化の出発点にする」(本レポートの提案) Advanced RAG 実践ガイド|新任テックリーダー向け 25
取込 検索 順位付け 生成 評価 運用・安全 2-A 分割方法に普遍的な正解はない 最良の分割法はタスクで入れ替わった:コーパス検索は段落分割、文書内検索は LLM 話題分割 コーパス検索(大量の文書から探す) • 強かった分割:単純な段落分割(複数モデルで) • 示唆:構造に沿った素直な分割が良い出発点 文書内検索(1文書の中から探す) • 強かった分割:LLM による話題分割 • 示唆:文書内の位置特定は意味的な境界が効く 注意 「Semantic Chunking(意味の切れ目で分割)を入れれば改善する」という一般化は支持されない。タスク種別ごとに比較する 採用判断 構造ベース分割・見出し付加・親子検索をまず比較対象にする。特定のチャンク長を全用途に一律指定しない 出典: Beyond Chunk-Then-Embed(2026, arXiv:2602.16974) Advanced RAG 実践ガイド|新任テックリーダー向け 26
取込 検索 順位付け 生成 評価 運用・安全 2-A チャンク長:最適値はデータと質問の型で動く 最近の比較では、最適な長さは 64〜1024 トークンの間で動く。各社の既定値も 300〜1024 とばらばら 資料 結論(条件) Rethinking Chunk Size( 2025) 事実を短く答える質問は 64〜128、広い文脈が要る質問は 512 〜1024 トークンが有利。埋め込みモデルでも最適値が変わる NVIDIA(自社パイプライン) ページ単位が平均 0.648 で最良・最も安定。事実型は 256〜 512、分析型は 1024 かページ。128 と 2048 は負けた Chroma(自社評価) 重なりを減らすと取得文脈の無駄が減る。OpenAI 既定 800/400 相当は多くの指標で下位 Semantic Chunking の評 価(2024) 意味の切れ目で分割しても、計算コストに見合う一貫した改善はない サービス 既定の長さ/重なり Amazon Bedrock KB 300 トークン/20% Azure AI Search(推奨) 512 トークン/25% OpenAI file search 800 トークン/400 Vertex AI RAG Engine 1,024 トークン/256 リーダーの視点 チャンク長は「評価で決めるパラメータ」。 128〜1024 トークンを候補に、質問の型ご とに測る。既定値はただの出発点 出典: Rethinking Chunk Size for Long-Document Retrieval(arXiv:2505.21700)、NVIDIA Technical Blog「Finding the Best Chunking Strategy」、Chroma Research「Evaluating Chunking Strategies」、各社ドキュメント(AWS Bedrock、Azure AI Search、OpenAI file search、Vertex AI RAG Engine) Advanced RAG 実践ガイド|新任テックリーダー向け 27
取込 検索 順位付け 生成 評価 運用・安全 2-A 長文コンテキスト時代の見直し:小さく検索して大きく読む LLM は 128k〜1M 読めるようになったが、1 ベクトルに詰めるほど検索は粗くなる。検索単位と読取単位を分ける Microsoft(自社評価):1 ベクトルのトークン数と 小さく検索して大きく読む Recall@50 50 45 • 検索:段落・100〜300 トークン程度の子チャンク 42.4 37.5 40 • 読取:親のセクションやページを返す(2-A 親子検索) 36.4 34.9 • 埋め込みの入力上限まで詰めない 35 30 25 20 15 10 52 → 72% +10.1pt LongRAG:約 4K トークン単位で検索 し長文モデルで読む(NQ、上位 1 件) Dense X:命題単位で検索(教師なし検 索器、Recall@20) 5 0 512 1,024 4,096 8,191 横軸:1 つのベクトルに入れたトークン数 出典: Microsoft Tech Community「Azure AI Search: Outperforming vector search with hybrid retrieval and reranking」(自社評価)、LongRAG( arXiv:2406.15319)、Dense X Retrieval(arXiv:2312.06648) Advanced RAG 実践ガイド|新任テックリーダー向け 28
取込 検索 順位付け 生成 評価 運用・安全 2-A 文脈は「件数 k × チャンク長」の予算:入れすぎると下がる 取得を増やすと再現率は上がり続けるが、回答品質は途中で頭打ち・低下する。予算は使い切らない Databricks(自社評価):文脈トークン量と再現率 1 0.89 0.95 OP-RAG:128 トークン片を原文順に 16k 渡す vs 全文約 117k を直接入れ る(Llama3.1-70B) 0.9 0.79 0.8 F1 44.4 vs 34.3 0.7 0.6 0.5 運用の目安 0.47 0.4 0.3 • 知識ベースが 20 万トークン未満なら、全文投入も候補( Anthropic) 0.2 • 使うなら k とチャンク長を「予算」として一緒に測る 0.1 • 重なりは 10〜25% から。増やすと文脈の無駄も増える • モデルを更新したら、頭打ちの点を測り直す 0 2k 8k 32k 128k 再現率は上がり続けるが、回答品質は 2024 年のモデルで 32k〜64k を超えると低下 出典: Databricks Blog「Long Context RAG Performance of LLMs」(自社評価、2024)、OP-RAG(arXiv:2409.01666)、Self-Route(arXiv:2407.16833)、 Anthropic「Contextual Retrieval」 Advanced RAG 実践ガイド|新任テックリーダー向け 29
取込 検索 順位付け 生成 評価 運用・安全 2-A 親子検索:検索の粒度と読解の粒度を分ける 小さな単位で正確に見つけ、親セクションや近隣文を後から読む。ただし広げすぎない上限を設ける 親チャンク:第4章 2節「休暇の繰越」 設計パラメータ • 子の単位(文・段落) 子1:繰越の対象となる休暇の種類… ① 子で検索してヒット 子2:繰越上限は20日とする。ただし… ② 親(または近隣の子)を読む → 「ただし」「例外」の条件も文脈 に入る • 親の単位(節・ページ) • 親の最大トークン数 • 同一親の重複排除 • 近隣の何文まで読むか 子3:前項の例外として、育児休業中は… 子4:申請手続きは人事システムで… 注意 親を無条件に広げると、トークン量とノイズが増えて Lost in the Middle(2-H)や費用増を招く 出典: 元レポート、A-RAG(文検索と親チャンク読取の分離) Advanced RAG 実践ガイド|新任テックリーダー向け 30
取込 検索 順位付け 生成 評価 運用・安全 2-A Contextual Retrieval:チャンクに文脈説明を前置する 文書全体とチャンクを LLM に渡し、50〜100 トークンの説明を生成してチャンクの前に付けてから索引化する 文書全体 Contextual Embedding LLM で文脈説明を生成 説明+チャンク Contextual BM25 チャンク 変換例(イメージ) 元のチャンク: 「前四半期比で売上は3%増加した。」 前置後: 「本チャンクは ACME 社の 2023年第2四半期決算報告の一部で、同期の売上動向 を述べている。」+元のチャンク 注意 説明文は LLM の生成物。原文と別フィ ールドに保存し、引用・検証には原文だけ を使う。全チャンク分の LLM 呼出し費用 と再索引時の再生成も見積もる 出典: Anthropic, Introducing Contextual Retrieval(開発元評価) Advanced RAG 実践ガイド|新任テックリーダー向け 31
取込 検索 順位付け 生成 評価 運用・安全 2-A Contextual Retrieval の効果をどう読むか 上位20件の検索失敗率。基準は「埋め込みのみ」で、−49% には BM25 を足した効果も含まれる。開発元評価 上位20件の検索失敗率(%、低いほど良い) 相対 −49% 7 6 文脈付き埋め込み+文脈付き BM25(5.7%→2.9%) 5.7% 5 相対 −67% 3.7% 4 再ランキング併用(5.7%→1.9%) 2.9% 3 1.9% 2 1 0 埋め込みのみ 文脈付き +文脈付き (基準) 埋め込み BM25 +再ランキング 採用判断 本資料の採用レーダー(Part 5)では Trial =実データで限定導入。主語・時点・主題が抜 け落ちる文書に有望。見出し付加・親子検索 と比較し、Late Chunking とは同時導入せ ず片方ずつ検証する 出典: Anthropic, Introducing Contextual Retrieval(開発元評価、1−Recall@20) Advanced RAG 実践ガイド|新任テックリーダー向け 32
取込 検索 順位付け 生成 評価 運用・安全 2-A 文脈は「何を付けるか」で選ぶ:LLM 生成か、機械的な見出しか LLM に説明を書かせなくても、文書名・会社名・年度・章のパスを機械的に前置するだけで大きく伸びた報告がある LLM が説明を書く • Anthropic:検索失敗 5.7% → 3.7% (文脈付き埋め込み) • 費用:全チャンクぶんの LLM 呼び出し、 更新時は作り直し メタデータを機械的に前置 • 「会社名: ○○; 年: 2023;」を前置で Context@5 33 → 55%(融合で 63%) 文書の短い要約を前置 • 約 150 文字の要約で、別文書を取る失 敗が大幅に減少(法律文書) • 150 字の方が 300 字より良かった • 会社名・年が効き、章名の効果は小さい リーダーの視点 共通点は「このチャンクはどの文書の、どこか」を補うこと。似た文書が多いほど効く。まず安い機械的な見出しから試し、足りなければ LLM 生 成へ 出典: Anthropic「Contextual Retrieval」(自社評価)、Utilizing Metadata for Better RAG(arXiv:2601.11863、ECIR 2026)、Summary-Augmented Chunking( arXiv:2510.06999)、dsRAG(Contextual Chunk Headers、自社評価) Advanced RAG 実践ガイド|新任テックリーダー向け 33
取込 検索 順位付け 生成 評価 運用・安全 2-A 表の文脈:ヘッダを毎回付ける、1 行を「列名: 値」に 表は分割すると列名が消え、数字の意味が分からない。ヘッダを繰り返すか、行を「列名: 値」に直す 変換前(2 つ目のチャンクに列名がない) | A-12 | 2.4 | 85 | 合格 | | A-13 | 2.6 | 88 | 合格 | 変換後①:表タイトルとヘッダを繰り返す 表3「受入試験の成績」(続き) | 型番 | 厚さ(mm) | 硬度 | 判定 | | A-12 | 2.4 | 85 | 合格 | 変換後②:1 行 1 レコードを「列名: 値」で [設計FMEA/故障モード一覧] 部品: ポンプP-200 故障モード: シール摩耗 重大度(S): 7 / 発生度(O): 4 対策: 定期交換 2/8 → 7/8 実践編:結合ヘッダの FMEA Excel を「列名: 値」の 1 行 1 レコードに(8 問) 注意 検索で最良の直列化形式(Markdown/JSON/列名: 値)はモデルとデータで変わる。LLM が表を読む評価と、検索の評価を混同しない 出典: Docling HybridChunker(repeat_table_header)、Unstructured chunking、AWS Bedrock Knowledge Bases(CSV)、TableRAG(arXiv:2410.04739)、 Table Meets LLM(arXiv:2305.13062)、実践編ケーススタディ Advanced RAG 実践ガイド|新任テックリーダー向け 34
取込 検索 順位付け 生成 評価 運用・安全 2-A 文脈の文量と、メタデータを「混ぜる/分ける」の判断 50〜100 トークンは実績値で最適値ではない。質問に出る語は本文に混ぜ、絞り込む値はフィルタに分ける 本文に混ぜる(埋め込みに入れる) フィルタに分ける 判断 質問文に自然に出る語 絞り込みに使う値 例 会社名・製品名・年度・文書タイトル・章名 部門・言語・日付・文書種別・ID 注意 型番の羅列は別文書を引き寄せる 強すぎると再現率が下がる(F1 38.9 → 37.3) 文量の目安 • 50〜100 トークンは観察値(比較の根拠なし) • 要約 150 字が 300 字より良かった(1 件) • チャンクの 1〜2 割以下。上限 512 のモデルは末 尾が切れる 34 / 38 / 37 問 実践編(48 問):見出しにファイル名/本文タイトル/両方。ファ イル名の型番が別文書を引き寄せた リーダーの視点 ファイル名は埋め込みに入れず、出典表示とフィルタに回すのが安全。 LlamaIndex も既定で file_name を埋め込みから外している 出典: Anthropic「Contextual Retrieval」、Summary-Augmented Chunking(arXiv:2510.06999)、arXiv:2510.24402(FinanceBench)、LlamaIndex Documents/Nodes、AWS Bedrock(includeForEmbedding)、実践編ケーススタディ Advanced RAG 実践ガイド|新任テックリーダー向け 35
取込 検索 順位付け 生成 評価 運用・安全 2-A Late Chunking:先に文脈化し、後で分割する 「分割→埋め込み」の順序を逆にし、文書全体を Transformer に通した後でチャンクごとにトークン表現を平均する 通常(Chunk-then-Embed) Late Chunking チャンクA チャンクB チャンクC 個別に埋め込み 個別に埋め込み 個別に埋め込み B の「同社」が何社かはベクトルに入らない 文書全体を長文エンコーダで文脈化(トークン表現) 各チャンクのベクトルに文書全体の文脈が反映される 52.4 → 54.3 全条件で低下 原論文:多数の文書から探すコーパス検索(BEIR )、nDCG@10 2026年比較:1 冊の中を探す文書内検索( GutenQA) 注意 長文対応エンコーダとトークン表現へのアク セスが必要。通常の「文書→ベクトル」API だ けでは同じ処理にならない 出典: Late Chunking(arXiv:2409.04701)、Beyond Chunk-Then-Embed(2026) Advanced RAG 実践ガイド|新任テックリーダー向け 36
取込 検索 順位付け 生成 評価 運用・安全 2-A Late Chunking はどんな文書に使い、どんな文書でやめるか 効くのは「多数の文書からどの文書か」を探すとき。1 冊の中を探すとチャンク同士が似てしまう 使う候補 やめる・慎重に 探し方 多数の文書から「どの文書か」を探す 1 冊・1 ファイルの中で「どの箇所か」を探す 文書の中身 1 文書 1 主題で、「同社」「本制度」など前を指す語が多い(契約 書、記事、報告書) 独立した話題の寄せ集め(FAQ 集、議事録の束、ログ、Excel の行レコード) 長さ エンコーダの最大長に収まる(数千トークン程度) 最大長を超える長大なマニュアル・書籍 環境 トークン単位の出力を取れる埋め込みモデルを自前で動かせる API で文を渡してベクトルを受け取るだけ リーダーの視点 判断は評価で:質問を「どの文書か」型と「文書内のどこか」型に分け、両方で通常の分割と比べる。前者だけ良くなるなら、文書内検索には使わ ない 出典: Late Chunking(arXiv:2409.04701、BEIR のコーパス検索)、Beyond Chunk-Then-Embed(arXiv:2602.16974、GutenQA の文書内検索)。使い分けは 2 つの結 果と仕組みからの推論 Advanced RAG 実践ガイド|新任テックリーダー向け 37
取込 検索 順位付け 生成 評価 運用・安全 2-A 3つの文脈補完手法の比較と採用判断 Contextual Retrieval と Late Chunking は「別の介入」。何を変えるかが違うので、効果の所在を分けて測る 手法 何を変えるか 実現方法 主な注意点 Contextual Retrieval 索引化するテキスト 文書全体+チャンクから 50〜100 トークンの 説明を生成し前置、Embedding と BM25 へ 説明文は生成物。原文と区別して保存・ 検証 Late Chunking 埋め込み計算と分割の順序 文書を文脈化した後、チャンクごとにトークン表 現を平均プーリング 長文エンコーダとトークン表現が必要。 文書内検索で不利になり得る 親子検索 検索単位と生成へ渡す単位 細粒度で検索後、対応する親チャンクを読む 無条件に広げるとトークンとノイズ増。 上限を設ける 採用判断 複雑な生成前処理に進む前に、構造ベース分割・見出し付加・親子検索を比較する。Contextual Retrieval と Late Chunking は同時導入せず、片方ずつアブレーションして改善の所在を確認する 出典: 元レポート「Contextual Retrieval と Late Chunking は別の介入である」 Advanced RAG 実践ガイド|新任テックリーダー向け 38
取込 検索 順位付け 生成 評価 運用・安全 2-B なぜハイブリッド検索が基本になるのか BM25 は強いゼロショットのベースライン。Dense はすべての分野で自動的に優位になるわけではない クエリの例 BM25(語彙) Dense(意味) 「XJ-4021 の保守期限」 ◎ 型番が一致 △ 型番の意味は学習され にくい 「第12条2項の解除要件」 ◎ 条項番号が一致 ○ 文脈次第 「解約したいときの手続き」 △ 文書側は「契約の終了」 ◎ 言い換えを吸収 「在宅勤務の通信費は出る?」 ○ 語の一致があれば ◎ 口語→規程表現 学習データにない専門領域 ○ 学習不要で安定 △ 領域外で性能差が大き い 基本形 • BM25 と Dense を並列実行 • 文書 ID・チャンク ID で候補を統合 • 順位ベースの RRF で融合(次頁) • メタデータ条件(ACL・版・有効日)を両方 に適用 採用判断 BM25+Dense の併用評価は Adopt。単一表現に依存させない 出典: BEIR(18 データセットの異種ベンチマーク)、元レポート「語彙と意味を補完させる」 Advanced RAG 実践ガイド|新任テックリーダー向け 39
取込 検索 順位付け 生成 評価 運用・安全 2-B RRF(Reciprocal Rank Fusion)を手で計算する スコアの尺度が違う検索器は「足せない」。順位だけを使って融合する RRF(d) = Σ_i 1 / ( c + r_i(d) ) c:定数(例 60)、r_i(d):検索器 i での順位 文書 BM25 順位 Dense 順 位 RRF(c=60) 融合後 B 2 1 1/62 + 1/61 = 0.03252 1位 A 1 3 1/61 + 1/63 = 0.03227 2位 C — 2 0 + 1/62 = 0.01613 3位 D 3 — 1/63 + 0 = 0.01587 4位 検証パラメータ • 定数 c(小さいほど上位重視) • 各検索器の候補件数 • 検索器ごとの重み • 片方にしか出ない文書の扱い 注意 BM25 スコア(例 12.3)とコサイン類似度(例 0.82)をそのまま足すと尺度の大きい側が支配する 出典: Cormack et al., Reciprocal Rank Fusion, SIGIR 2009 Advanced RAG 実践ガイド|新任テックリーダー向け 40
取込 検索 順位付け 生成 評価 運用・安全 2-B 埋め込みモデルの選定:BGE-M3 と日本語の現実 多言語・複数表現を1モデルで扱う選択肢がある。ただし公開ベンチマークは日本語業務での効果を保証しない 補足(元レポート外の一般知識) BGE-M3:1モデル3表現 • Dense:文全体の意味ベクトル • 学習型 Sparse:語ごとの重み(BM25 的) • Multi-vector:トークン単位(ColBERT 的) 70.0 vs 65.4 MIRACL 18 言語の平均 nDCG@10(日本語単独ではない)。BGE-M3 の 3 表現併用 vs 多言語 E5(mE5-large) 日本語の候補絞り込みには JMTEB(日本語埋め込みベンチマ ーク)が使える。日本語特化の Ruri 系、多言語の multilingual-e5・BGE-M3 等が候補。 ただしモデルカードの値は自己報告で、別環境で再現しなかっ た報告もある。プレフィックス指定など使用条件も確認する リーダーの視点 公開ベンチマーク=候補を絞る道具。最終判断は自社評価 セット(日英混在・社内略語・表記ゆれを含む)で行う 出典: BGE-M3(arXiv:2402.03216)/補足:JMTEB、Ruri(arXiv:2409.07737)、cl-nagoya/ruri-v3 モデルカード Advanced RAG 実践ガイド|新任テックリーダー向け 41
取込 検索 順位付け 生成 評価 運用・安全 2-B バイエンコーダ・クロスエンコーダ・Late Interaction 「別々に符号化して速く広く」→「一緒に読んで精密に」。速度・精度・容量のトレードオフで役割を分ける バイエンコーダ Late Interaction クロスエンコーダ Dense 検索 ColBERT 系 再ランキング 質問と文書を別々に1ベクトル化 → 類似度 トークンごとの複数ベクトル。質問トークンご とに最大類似度を合計(MaxSim) 質問と文書を連結して一緒に入力し関連度 を直接判定 ◎ 文書側を事前計算・高速 ○ 細粒度の一致 ◎ 高精度 △ 細かな一致を取りこぼす △ 索引容量が大きい ✕ 候補ごとに推論・大量文書に不向き 主な役割 主な役割 主な役割 候補検索(広く) 候補検索/再順位 上位候補の再順位(精密に) 出典: BEIR、ColBERTv2(arXiv:2112.01488) Advanced RAG 実践ガイド|新任テックリーダー向け 42
取込 検索 順位付け 生成 評価 運用・安全 2-B Late Interaction の代償:索引容量 ColBERTv2 は残差圧縮で容量を約 1/6〜1/10 に削減。それでも圧縮後の索引容量とメモリは実測が必須 MS MARCO の索引容量(GiB) 採用時に測るもの 180 160 154 • 索引サイズとメモリ常駐量 • 検索遅延(p95)と同時実行数 • 索引の更新・削除反映時間 • 実装・運用の複雑さ(専用エンジンの要否) 140 120 100 80 60 40 25 16 20 リーダーの視点 「精度 +X」の提案には必ず「容量・費用・運用負荷 +Y」を並べて示す 0 ColBERT(従来) ColBERTv2 (1 bit 圧縮) ColBERTv2 (2 bit 圧縮) 出典: ColBERTv2(MS MARCO 条件) Advanced RAG 実践ガイド|新任テックリーダー向け 43
取込 検索 順位付け 生成 評価 運用・安全 2-B 再ランキングは「足せば必ず効く」部品ではない BEIR では 18 中 16 で改善。だが推論が要る BRIGHT では、話題の一致で学んだ小型モデルが逆効果 16 / 18 BEIR:BM25+クロスエンコーダが BM25 を上回ったデータセット数 BRIGHT:平均 nDCG@10 20 17.4 18 16 14.3 14 13.1 12 10 8 ポイント BRIGHT=関連の判定に推論が要 る検索。GPT-4 は推論できるので 改善した。効くかは「関連の性質」と モデル次第 6 4 2 0 BM25 のみ +MiniLM 再ランキング +GPT-4 再ランキング (MS MARCO 学習) 採用判断 候補検索の Recall と、再ランキング後の nDCG を別々に測る。候補に必要文書がなければ再ランキングでは救えないので、候補生成の失敗 を先に直す 出典: BEIR、BRIGHT(arXiv:2407.12883) Advanced RAG 実践ガイド|新任テックリーダー向け 44
取込 検索 順位付け 生成 評価 運用・安全 2-B 検索段の設計:2段構えのファネル 検索は 2 段(候補検索→再ランキング)で、後の 2 段は生成側。件数例:候補 100 件→10 件→文脈に 5 件 候補検索 BM25 と Dense を並列 → RRF 融合 指標:Recall@k 再ランキング クロスエンコーダ等で精密に並べ替え 指標:nDCG@k・MRR 文脈構成 親チャンク拡張・重複除去・予算内選択 指標:必要な根拠が文脈に入った割合 生成 引用付き回答 指標:EM・忠実性・引用 リーダーの視点 各段の件数(何件集め、何件に絞るか)は普遍値ではなく評価で決めるパラメータ。「なぜその件数か」を説明できるようにする 出典: 元レポート「候補検索・ハイブリッド・再ランキング」 Advanced RAG 実践ガイド|新任テックリーダー向け 45
取込 検索 順位付け 生成 評価 運用・安全 2-C HyDE:質問を「仮想的な回答文書」に写像する LLM に仮想文書を書かせ、それを埋め込んで実コーパスを検索する。最終回答の根拠は実文書から取る 質問 LLM が仮想文書を生成 仮想文書を埋め込み 実コーパスを検索 実文書を根拠に回答 仮想文書は「検索の橋渡し」。内容が事実である必要はないが、証拠として使ってはならない TREC DL19:nDCG@10 70 ポイント 61.3 62.1 Contriever +HyDE 参考:MS MARCO 60 50 44.5 40 ゼロショット(学習データなし)での改善 策。微調整済みの検索器を上回ったわけ ではない。既に領域最適化した検索器に 同じ効果があるとはみなさない 30 20 10 0 Contriever (ラベルなし学習) で教師あり学習 出典: HyDE(arXiv:2212.10496)、TREC DL19 Advanced RAG 実践ガイド|新任テックリーダー向け 46
取込 検索 順位付け 生成 評価 運用・安全 2-C 質問分解と推論による検索拡張 多段の質問では、最終回答と同じ表現の文書が最初から存在するとは限らない。中間事実を順に調べる 元の質問:「主力製品 X の主要部品のサプライヤー所在国で、2026年に施行された輸出規制は?」 Q1 製品 X の主要部品は? → 部品 P Q2 部品 P のサプライヤーは? →S社 Q3 S 社の所在国は? →国N Q4 国 N で 2026年施行の輸出 規制は? → 回答 前のサブ質問の答えが、次の検索語になる(順序依存) 最大 +12.2pt BRIGHT:LLM の推論ステップでクエリ拡張した場 合 注意 前段の誤り(部品 P の取り違え)は後段にすべて伝播する。各ホップで根拠を記録し 、途中の到達率を評価する(Part 3) 出典: BRIGHT(LLM の推論ステップでクエリ拡張し最大 12.2pt 改善) Advanced RAG 実践ガイド|新任テックリーダー向け 47
取込 検索 順位付け 生成 評価 運用・安全 2-C クエリ系の実装原則と採用判断 元質問・書換質問・サブ質問・仮説を別々の型として保持し、生成した仮説を証拠に混ぜない 元質問 ユーザー入力そのもの。最終照合の基準 書換質問 語彙のずれを埋めた検索用表現 サブ質問 多段質問の分解単位。順序と依存を持つ 仮説(HyDE 等) 検索の橋渡し専用。証拠ストアに入れない 実装ルール • 元の年・対象・除外条件を失わないよう、検索結果を元質問 に再照合 • 仮説を「確認済みの事実」として証拠ストアへ混入させない • どのクエリがどの候補を生み、どれを採用したかをログに残 す 採用判断 語彙のずれには書換・HyDE、未確定の中間事実を順に調べる質問には分解・反復検索を使い分ける(Trial) 出典: 元レポート「質問分解と推論拡張」 Advanced RAG 実践ガイド|新任テックリーダー向け 48
取込 検索 順位付け 生成 評価 運用・安全 2-D RAPTOR:抽象度をまたいで検索する チャンクの埋め込み・クラスタリング・要約を再帰的に行い、原文と複数階層の要約から検索する QuALITY 正解率(%):読解は GPT-3 に固定し、検 ルート要約 索方式だけ比較 70 60 要約 1 要約 2 57.3 60.4 62.4 DPR RAPTOR 50 40 30 c1 c2 c3 c4 c5 c6 20 10 原文チャンク(葉)→ クラスタ要約 → さらに要約。全ノードが検索対象 0 BM25 注意 要約は誤りを含み得る。要約ノード→原文リンクを保持し最終引用は原文へ戻す。原文更新時の要約の再生成範囲(更新波及)を管理し、数値・ 例外条件を要約だけで確定しない 出典: RAPTOR(arXiv:2401.18059)、QuALITY 開発セット Advanced RAG 実践ガイド|新任テックリーダー向け 49
取込 検索 順位付け 生成 評価 運用・安全 2-D 「GraphRAG」は単一の手法ではない 同じ名称で、グラフの中身も検索方法も向く質問も異なる。目的を決めてから系統を選ぶ 系統 グラフ・索引の内容 検索・推論方法 向く質問 Microsoft GraphRAG Global Search エンティティ・関係、コミュニティ、階層 要約 コミュニティ要約から部分回答を作り mapreduce で統合 コーパス全体のテーマ・論点・傾向 LightRAG エンティティ・関係とその説明、ベクトル 索引 低レベル・高レベルのキーワード検索と近傍情 報を統合 個別対象と広い概念を併用する探索 HippoRAG 2 句・三つ組・パッセージの接続 三つ組検索、LLM による選別、 Personalized PageRank で原文を順位付 け 複数文書にまたがる事実・関連性の 探索 HopRAG パッセージと LLM 生成疑似質問の論 理的接続 retrieve–reason–prune で関連パッセージ を辿る 語彙・意味類似だけでは辿れない多 段 QA リーダーの視点 「GraphRAG を入れたい」と言われたら「何を辿りたいのか(全体の論点か、文書間の関係か)」を最初に問う 出典: GraphRAG(arXiv:2404.16130)・公式 Global Search 仕様、LightRAG、HippoRAG 2、HopRAG Advanced RAG 実践ガイド|新任テックリーダー向け 50
取込 検索 順位付け 生成 評価 運用・安全 2-D Microsoft GraphRAG Global Search の仕組み コーパス全体の「論点把握」向け。勝率 72〜83% は LLM 判定の包括性比較であり、事実 QA の正解率ではない エンティティ・関係抽出 コミュニティ検出 コミュニティ要約 map reduce LLM でテキストから 関連の強いまとまり 階層的に作成 各要約から部分回答 部分回答を統合 索引作成(事前・高コスト) 72〜83% 意味検索に対する「包括性」の LLM 判定勝率(約100万・ 170万トークンの2コーパス、全体質問) 質問時 向く質問 向かない・注意 • 「この1年の障害報告の主なテーマは? 」 • 特定の事実を1つ答える QA • 「顧客の声で多い論点は?」 • 階層の選択で詳細さ・費用が変化 • 更新頻度が高いコーパス(再構築費用) 出典: GraphRAG(arXiv:2404.16130)、GraphRAG 公式仕様 Global Search Advanced RAG 実践ガイド|新任テックリーダー向け 51
取込 検索 順位付け 生成 評価 運用・安全 2-D HippoRAG 2:得るものと払うもの HippoRAG 2 vs 標準 RAG(NV-Embed-v2)。多段の Recall は大幅改善、F1 は +2.8。費用は別データの値 得るもの 払うもの 59.8 vs 57.0 99.5 分 vs 12.1 分 7データセット平均 QA F1(標準 RAG 比 +2.8) MuSiQue 条件の索引時間 90.4 vs 76.5 1.2 秒 vs 0.3 秒 2Wiki の Recall@5(多段検索) MuSiQue 条件の QA 時間 リーダーの視点 全体平均の差が小さくても、特定カテゴリ(多段質問)では大きく効くことがある。カテゴリ別評価と費用・遅延の比較をセットで示す 出典: HippoRAG 2(arXiv:2502.14802)、同一回答モデル Llama-3.3-70B-Instruct Advanced RAG 実践ガイド|新任テックリーダー向け 52
取込 検索 順位付け 生成 評価 運用・安全 2-D 2026年の比較研究が示すことと採用判断 Agentic 化で Dense も伸び差は縮む。複雑な多段ではグラフ有利が残るが、一般 QA で一貫した優位はない Agentic 化の効果 Dense RAG を Agentic にすると性 能が上がり、グラフとの差が縮まる グラフが残る場面 複雑なマルチホップ質問では、グラフ側 が有利な場面が残る 一般 QA 一貫した優位はない。「一律優位」も「不 要」も言えない 注意 一部比較は「データセットごとに複数グラフ手法の最良値」を取る形式で単一構成の実運用性能ではない。LightRAG 等の LLM 選好勝率は EM・F1 と同じ尺度で並べられない 採用判断 グラフを先に構築しない。「何を辿る必要があるか」を定義してから選ぶ。抽出した関係は確認済みの因果とは限らないので、原文・版・抽出方法 の追跡を必須とする(Trial:用途限定 GraphRAG) 出典: RAGSearch(arXiv:2604.09666)、LightRAG Advanced RAG 実践ガイド|新任テックリーダー向け 53
取込 検索 順位付け 生成 評価 運用・安全 2-E Self-RAG・CRAG・Agentic RAG を区別する 「自己反省ループ」と一括りにしない。学習による制御/評価器による分岐/ツールを選ぶエージェントは別物 Self-RAG CRAG Agentic RAG 学習による制御 評価器による分岐 ツールを選ぶ 仕組み 仕組み 仕組み 検索要否・文書の関連性・生成文の支持 を reflection token として出力する よう学習 検索評価器の信頼度に応じ、利用/分解 ・選別/外部検索を切り替える 検索語・粒度・読取範囲・停止条件をモデ ルが選ぶ(例:A-RAG) 注意点 注意点 注意点 プロンプトで「自己反省せよ」と指示するル ープとは別物。効果には学習済みモデルの 能力が含まれる Self-RAG に CRAG を足すと PopQA で 54.9→61.8 だが、選択式の ARC で は 67.3→67.2。全タスクで有効ではない 本質は検索回数ではなく「選択」。停止判断 の評価が不可欠 出典: Self-RAG(ICLR 2024)、Corrective RAG(arXiv:2401.15884)、A-RAG(arXiv:2602.03442) Advanced RAG 実践ガイド|新任テックリーダー向け 54
取込 検索 順位付け 生成 評価 運用・安全 2-E 企業内で CRAG 型を使うときの分岐設計 「不足時に Web 検索」をそのまま採用しない。外部検索の許可・機密漏洩・情報の優先順位を明示する 高:取得文書をそのまま利用 外部検索の前に決めること • 外部検索を許可するか(データ分類ごと) • 質問文の機密(顧客名・未公開情報)の送信 可否 検索評価器の信頼度 曖昧:分解・選別して利用、追加検索 • 社内ルールと外部一般情報が矛盾した時の 優先順位 • 外部情報を使った回答の明示 低:許可された社内の別データ源 → それでも不 足なら棄権 リーダーの視点 論文の設計を社内にそのまま持ち込まない。セキュリティ・法務と「外部に出してよい情報」を先に合意する 出典: 元レポート「自己評価とエージェント制御を区別する」 Advanced RAG 実践ガイド|新任テックリーダー向け 55
取込 検索 順位付け 生成 評価 運用・安全 2-E A-RAG:検索ツールの粒度をモデルに公開する キーワード検索・意味検索・チャンク読取を別ツールとして渡し、必要な親チャンクだけを読ませる MuSiQue LLM-Acc キーワード検索 型番・固有名詞を正確に 74.1 80 66.2 70 意味検索 文単位で当たりをつける 60 取得トークン数(千) 52.8 30 必要な親チャンクだけ読む 56.4 50 50 40 チャンク読取 60 40 30 20 10 20 0 10 + 既読管理で再読を抑制 5.7 0 単純 Agentic A-RAG Full ※ 取得トークンの比較。総推論トークン・金額・遅延が同率で減る意味ではない 出典: A-RAG(arXiv:2602.03442、MuSiQue、回答モデル GPT-5-mini、LLM-Acc は著者評価器による意味的一致) Advanced RAG 実践ガイド|新任テックリーダー向け 56
取込 検索 順位付け 生成 評価 運用・安全 2-E 停止は検索そのものと同じくらい重要 多段ベンチマークの最も難しい質問群では GPT-5 でも EM 22.6%。主な失敗は「早すぎる終了」と「過剰な延長」 提案:証拠照合に基づく状態機械 22.6% 計画(サブ質問) 検索・読取 最も難しい質問群での GPT-5 の EM(完 全一致率) 早期終了 証拠照合 終了判定 不足 終了理由を区別して記録する(評価・監査に使う) 証拠不足のまま回答 充足 引用付き生成へ 予算超過 回答範囲を限定 権限不足 理由を示して棄権 根拠不存在 「見つからない」と回答 矛盾未解消 両論併記か確認依頼 ポイント 過剰な延長 回答モデルの自己申告(「十分です」)だけ で終了を決めない。必要なサブ質問と取 得済み証拠を外部で照合する 充足後も探索を続け迷走 出典: AgenticRAGTracer(Findings of ACL 2026、中間ホップ付き 1,305 件) Advanced RAG 実践ガイド|新任テックリーダー向け 57
取込 検索 順位付け 生成 評価 運用・安全 2-E Agentic RAG の制御項目 予算・状態・終了理由は LLM の判断だけに任せず、外部のオーケストレータで決定的に管理する 制御項目 提案する実装 ステップ予算 最大ツール回数・経過時間・推論量を外部オーケストレータで制限 証拠の増分 新規文書、未解決主張の解消、既読重複を記録(進捗のない探索を検出) 検索状態 クエリ、検索対象、ACL、時点、候補、採用根拠を保存 終了状態 充足、予算超過、権限不足、根拠不存在、矛盾未解消を区別 非同期・並列 独立したサブ質問のみ並列化し、前提依存の検索は順序を守る 回答品質 最終正解率に加え、ホップごとの根拠到達率と停止の適切さを測定 リーダーの視点 Agent の失敗は「最終回答が違う」だけでは原因が分からない。検索状態と終了理由のトレースを初期実装から残す 出典: 元レポート「停止は検索そのものと同じくらい重要」(本レポートの提案する実装) Advanced RAG 実践ガイド|新任テックリーダー向け 58
取込 検索 順位付け 生成 評価 運用・安全 2-E ルーティング:全質問を Agentic にしない 通常検索で解ける質問は短い経路に保ち、複合質問だけを Agentic 経路へ振り分ける 単純・単一ホップ 通常経路:ハイブリッド+再ランキング 評価すること • ルータの誤分類率 • 経路別の成功率 全問い合わせ タスク分類(ルータ) 全体要約 コミュニティ要約等 • 全トラフィックの費用・p95 遅 延 • 経路ごとの失敗内訳 多段・複合 予算付き Agentic 経路 採用判断 通常検索で解ける問いは短い経路に保ち、複合質問のみ Agentic 経路へ。ルータ自体の誤分類も評価し、全トラフィックでの費用対効果を測 る 出典: 元レポート「Adaptive・Corrective・Agentic RAG」採用判断、採用レーダー(Hold:全問への無制限な反復検索) Advanced RAG 実践ガイド|新任テックリーダー向け 59
取込 検索 順位付け 生成 評価 運用・安全 2-F RAFT:検索文脈の「使い方」を学習する 正解文書と無関係文書を混ぜた訓練例で、根拠から引用して答える力と、ノイズを無視する力を学習させる 訓練例の構成 運用で必要なこと 質問 正解文書 無関係文書 無関係文書 無関係文書 • 文書や回答形式の変化を含む時系列テストを 設ける • 索引更新だけで済む部分と、再学習が必要な 部分を分ける 教師:正解文書から引用して推論する回答 効く場面 固定的な専門領域で、文書を与えてもモ デルが使いこなせない場合 • 学習データの作成・更新体制 • ベースモデル更新時の再学習費用 限界 別領域・大幅に更新されたコーパスへの 一般化は保証されない 出典: RAFT(arXiv:2403.10131) Advanced RAG 実践ガイド|新任テックリーダー向け 60
取込 検索 順位付け 生成 評価 運用・安全 2-F Search-R1:検索の方策を強化学習する 推論・検索・回答を交互に行う軌跡を、最終回答の正しさを報酬に強化学習で最適化する 推論 検索 何が必要か考える クエリを発行 0.304 → 0.431 7 QA データセット平均 EM(RAG ベースライン → Search-R1、7B) +12.7pt、相対約 41.8% 読む 検索結果は自分の出力で ないので学習対象外 …繰り返し 回答 正しさ=報酬 注意 報酬設計の落とし穴: 正解文字列だけの報酬は「正解だが権限外の根拠を使用」「引用が誤り」「古 い回答」を区別できない。これらを検証項目として報酬・評価に含める 採用判断 独自モデルの訓練(RAFT は Trial、検索方策 RL は Assess)は、検索器・評価セット・報酬定義・更新検知を整えた後に検討する。 学習投資は基盤が固まってからの最後の手段 出典: Search-R1(arXiv:2503.09516、E5 検索器・2018年 Wikipedia 等、7B モデル) Advanced RAG 実践ガイド|新任テックリーダー向け 61
取込 検索 順位付け 生成 評価 運用・安全 2-G 視覚文書検索:OCR 中心とページ画像中心 ColPali はページ画像を VLM で複数ベクトル化し、テキストクエリと Late Interaction で照合する OCR・テキスト中心 ページ画像中心(ColPali 系) • 軽量・既存の検索基盤を流用 • 図表・スライド・スキャン PDF に強い • 図表・配置の情報が欠落しやすい • 索引容量が大きい・引用箇所の特定が課 題 81.3 / 86.6 ViDoRe 平均 nDCG@5(ColPali / ColQwen2) 257.5 KB/頁 ColPali float16 表現の容量 補足(元レポート外の一般知識) 採用判断 容量の概算:100万ページ × 257.5 KB ≈ 258 GB(単純計 算。圧縮・量子化・プーリングで変わる)。ページ数 × 1頁容量で 事前に見積もる 画像検索か OCR かを二者択一にしない。本文検索・表の構造 化・ページ画像検索を同じページ ID に紐づけ、必要なページ・ 領域だけを視覚モデルへ送り、引用は元ページと箇所を提示す る(Trial) 出典: ColPali(arXiv:2407.01449、ViDoRe ベンチマーク) Advanced RAG 実践ガイド|新任テックリーダー向け 62
取込 検索 順位付け 生成 評価 運用・安全 2-G 表と数値:検索と計算を分離する 表を含む QA は「正しい表を探す」と「正しく計算する」の2つの失敗を持つ。別々にテストする 31% MLPerf 参照 RAG:数値の質問・表の質問と も正答率 31%。検索と計算のどちらの失敗 か分からない 表の検索 Hybrid(Dense+ Sparse)で正しい表・ 行を探す 値の抽出 計算 行・列・単位・期間を特 定 決定的なツールで実 行 ← 検索成功のテスト → 回答 使った行列・式を明示 ← 計算成功のテスト → ※ 当該参照構成の値であって、RAG 全般や最新モデ ルの上限ではない 採用判断 監査可能な数値回答では、取得した行・列、単位、期間、計算式を明示する。計算は可能 な限り決定的なツールに分離し、検索成功と計算成功を別のテストで検証する ポイント T²-RAGBench の抄録は BM25+Dense のハイブリッドの有効性を報告(詳細スコアは未確認のため効果量は示さない) 出典: T²-RAGBench(EACL 2026、23,088 件)、MLPerf End-to-End RAG(MLCommons 2026) Advanced RAG 実践ガイド|新任テックリーダー向け 63
取込 検索 順位付け 生成 評価 運用・安全 2-H 長文コンテキスト:「RAG か長文か」ではなく組み合わせ 検索で対象文書を絞り、必要な文書はセクションや全文を長めに読む。長文読解は RAG の「読取段階」として使える 概念図:関連情報の位置と性能(数値は説明用の模式 2025年の再評価 値) 80 75 72 75 70 63 62 65 60 外部文脈が必要な質問に絞ると全体では長文が優位。それでも絞るのは、 全社文書は窓に入らず、権限・費用・遅延でも有利だから。RAG のみ正答 する質問もある 55 55 50 45 40 先頭 前半 中央 後半 検索で絞る 長めに読む 対象文書を数件に セクション・全文 引用付き生成 末尾 ※ Lost in the Middle の傾向を示す模式図。実測値ではない。最新モデルでの劣 化量は採用候補で測る ポイント 位置依存性・長文読解力はモデル世代で変わる。モデル更新のたび に再測定する 出典: Lost in the Middle(arXiv:2307.03172)、Long Context vs. RAG(2025, arXiv:2501.01880) Advanced RAG 実践ガイド|新任テックリーダー向け 64
取込 検索 順位付け 生成 評価 運用・安全 2-H コンテキスト圧縮は根拠を改変するリスクも持つ 圧縮でノイズが減り EM は上がった(英語会議録)。だが否定・条件が 1 語落ちれば意味が逆転する QA EM トークン数 保護すべき要素 90 3500 3,003 3000 70 2500 2000 1500 970 1000 76.22 80 • 否定語(〜しない) 66.95 • 数値・単位 60 • 条件節(ただし・を除く) 50 • 出典 ID 40 • → 圧縮前後の回答差を測る 30 20 500 10 0 0 原文 圧縮後 原文 圧縮後 採用判断 圧縮前に重複除去・親チャンクの読取範囲制御・不要文書の除外を試す。高度な圧縮(Assess)は、コスト削減と証拠保持を同時に評価できる 用途に限定。最終引用用の原文は失わない 出典: LLMLingua-2(arXiv:2403.12968、MeetingBank・Mistral-7B 条件) Advanced RAG 実践ガイド|新任テックリーダー向け 65
取込 検索 順位付け 生成 評価 運用・安全 定量エビデンス台帳①:検索・前処理系 効果の種類と比較条件を残した抜粋。行をまたいだスコアの大小は手法のランキングを意味しない 手法・資料 条件・指標 比較結果 解釈・限界 BEIR 再ランキング 18 データセット、nDCG@10 BM25+クロスエンコーダ(CE)が 16/18 で BM25 超え 検索順位の改善。回答効果ではない Contextual Retrieval 開発元評価、1−Recall@20 埋め込みのみ 5.7% → 文脈付与+BM25 2.9% → +再ランク 1.9% 失敗率の相対 49%・67% 減。正解率の 改善率ではない Late Chunking 3モデル・4 BEIR、5文単位 平均 nDCG@10 52.4 → 54.3 コーパス検索で +1.9pt。文書内検索で は逆効果(チャンク同士が似る) BGE-M3 MIRACL 18言語、nDCG@10 mE5-large 65.4 / BGE-M3 70.0(別モ デル) 別モデル間の比較。日本語業務精度では ない HyDE TREC DL19、nDCG@10 Contriever 44.5 → 61.3(参考:教師あり 62.1) ゼロショット改善。教師ありを上回っては いない RAPTOR QuALITY 開発、同一 GPT-3、正解 率 BM25 57.3、DPR 60.4、RAPTOR 62.4 読解モデルを揃えた比較を採用 出典: 元レポート「定量エビデンスの比較台帳」(各論文・記事) Advanced RAG 実践ガイド|新任テックリーダー向け 66
取込 検索 順位付け 生成 評価 運用・安全 定量エビデンス台帳②:グラフ・Agent・学習・引用 指標が EM・F1・LLM-Acc・LLM 選好・引用再現率とバラバラ。同じ「精度」として並べない 手法・資料 条件・指標 比較結果 解釈・限界 GraphRAG 2コーパスの全体質問、LLM 選好 意味検索に対する包括性勝率 72〜83% 正解率ではない。全体要約タスクでの証拠 HippoRAG 2 同一 Llama-3.3-70B、7データセット平均 QA F1 NV-Embed-v2 RAG 57.0 → 59.8 絶対 +2.8。多段検索の改善と全体平均を 区別 HopRAG 3多段 QA 平均、GPT-4o、EM/F1 SiReRAG 53.93/65.83 → 55.10/66.40 強い比較相手との差は +1.17/+0.57pt 。探索呼出しも要確認 A-RAG MuSiQue、GPT-5-mini、LLM-Acc Naive RAG 52.8 → Full 74.1 著者の評価器による意味的一致。EM では ない Search-R1 E5+2018 Wikipedia、7B、7 QA 平均 EM RAG 0.304 → 0.431 +12.7pt、相対約 41.8%。学習込みの比 較 ALCE ASQA、ChatGPT、引用再現率 引用の良い回答を選び直すと 73.6 → 84.8、正確性 40.4 → 40.2 引用改善が正確性改善と同義でない 出典: 元レポート「定量エビデンスの比較台帳」(各論文) Advanced RAG 実践ガイド|新任テックリーダー向け 67
PART 3 評価:何を測れば効果を判 定できるか このPartで答えられるようになる問い • 自動評価(LLM 評価器)はどこまで信用できるか? • どの層で何を測れば失敗を分離できるか? • 比較実験はどの順序・条件で行うか? • 評価セットはどう作り、どう比較を統計的に正しく行 うか? 評価基盤はプロジェクトの「計器」。手法選定より先に作り、す べての判断をここに通す 68
取込 検索 順位付け 生成 評価 運用・安全 自動評価は人手評価の「代用品」ではなく「増幅器」 LLM 評価器は人手ラベルで較正して初めて信頼できる。指標ごとに信頼性も違う Ragas ARES ALCE • 参照回答なしで測定:Faithfulness・ Answer / Context Relevance • 方式:合成データで軽量評価器を訓練し、 少量の人手ラベルで偏りを補正(PPI) • 方式:流暢さ・正しさ・引用品質を分けて 評価 • 人手との一致(二者比較で同じ側を選ん だ率):Faithfulness 0.95 / Context Relevance 0.70 • 限界:大きな領域移行で評価器の性能が 低下 • 示唆:引用再現率↑でも正確性は不変の 例。「引用付き=正しい」ではない リーダーの視点 英語の一般タスクで得た評価器の一致率を、日本語の専門業務へそのまま持ち込まない。自社ドメインの人手ラベル(専門家)を少量 でも必ず用意し、評価器を較正する 出典: Ragas(arXiv:2309.15217、WikiEval)、ARES(arXiv:2311.09476)、ALCE(arXiv:2305.14627) Advanced RAG 実践ガイド|新任テックリーダー向け 69
取込 検索 順位付け 生成 評価 運用・安全 層別の評価設計:失敗を分離できる指標を置く 最終正解率だけでは「どこで壊れたか」が分からない。層ごとに指標と分離したい失敗を対応させる 層 主な指標 分離したい失敗 取り込み 表構造・見出し・原文位置の保持、抽出漏れ そもそも索引化されていない 候補検索 Recall@k、根拠文書の完全被覆率 重要文書が候補に入らない 順位付け nDCG@k、MRR、予算内の根拠被覆 候補にはあるが採用されない 生成 EM/F1、専門家正解率、計算正確性 根拠を渡しても誤る 引用 支持される主張の割合、引用の適切さ、原文追跡 正しい回答と誤った引用の混在 棄権 回答率対エラー率、根拠不存在時の誤答率 無理に回答する/答えられるのに棄権 Agent ホップ成功率、停止適切性、重複探索率 早期終了・過剰検索・迷走 運用 p50/p95/p99、費用/問、索引更新・削除反映時間 平均値で隠れる長尾・古いデータ 安全性 権限外露出、注入耐性、汚染成功率 品質向上と引き換えの情報漏洩 出典: 元レポート「推奨する評価設計」(本レポートの提案) Advanced RAG 実践ガイド|新任テックリーダー向け 70
取込 検索 順位付け 生成 評価 運用・安全 比較実験の手順:Oracle から段階的に積み上げる まず「正解根拠を直接与えた」上限を測る。Dense と BM25 は並列のベースラインで、Hybrid はその融合 Oracle Context 正解根拠を直接与える =読解の上限 Dense BM25 ベースライン① ベースライン② Oracle で分かること Hybrid ①②を順位で融合( RRF) +Reranker +高度化 再ランキング 失敗原因に応じて 実験の作法 • Oracle でも低い → 生成側(モデル・プロンプト・文書品質)の問題 • 回答モデル・評価器・プロンプトを固定して段階比較 • Oracle は高いが実検索で低い → 検索側の問題。差が改善余地 • モデル・推論努力量の変更は別軸の実験にする • 各段の費用・遅延も同時に記録 リーダーの視点 2つの変数を同時に動かさない。「モデルも検索も変えたら良くなった」では次の判断に使えない 出典: 元レポート「推奨する評価設計」 Advanced RAG 実践ガイド|新任テックリーダー向け 71
取込 検索 順位付け 生成 評価 運用・安全 評価セットの作り方:カテゴリで分けて劣化を見逃さない 全体平均と重要カテゴリの劣化を同時に確認する。質問だけでなく文書・版・時点のリークも避ける 分けるべき質問カテゴリ リークを避ける 単一ホップ 否定・例外条件 多段 古い情報 全体要約 回答不能 図表 権限不足 数値 日英混在 • 質問の重複だけでなく • 同一文書の別版・同一時点の情報が調整用と評 価用にまたがらないよう分割 赤:見落とされやすいが業務上重大なカテゴリ 補足(元レポート外の一般知識) 作成手順の例:①実際の問い合わせログ・FAQ から質問を収集 ②業務担当者(SME)が正解と根拠箇所をラベル付け ③カテゴリを 付与 ④回答不能・権限不足の質問を意図的に追加 ⑤本番で見つかった失敗を回帰セットへ継続追加 出典: 元レポート「推奨する評価設計」/作成手順の一部は補足 Advanced RAG 実践ガイド|新任テックリーダー向け 72
取込 検索 順位付け 生成 評価 運用・安全 比較を統計的に正しく行う 同じ質問で対応のある比較を行い、信頼区間で判断する。平均の小差より重大誤答と遅い側の応答時間(p99)を見る 対応のある比較 同じ質問集合で両構成を実行し、質問ごとの差を集計。難易度の ばらつきを相殺 評価器の固定 LLM 評価器のプロンプト・モデル版・提示順序を固定。変えたら再 評価 信頼区間 差に区間を付けて判断(例:ブートストラップ※補足)。点推定だけ で採否を決めない 平均以外を見る 重大誤答の減少、p95/p99 遅延の悪化を別途評価して採否を 決める 出典: 元レポート「推奨する評価設計」/ブートストラップ等の手法名は補足 Advanced RAG 実践ガイド|新任テックリーダー向け 73
取込 検索 順位付け 生成 評価 運用・安全 2026年の評価動向:E2E・途中ホップ・大規模へ 検索単体の評価から、Agent が作る長く具体的なクエリ・大規模コーパス・途中の各段・取込〜回答の通し評価へ 評価対象の拡張 確認した動き 実務への示唆 Agent 生成クエリと大規模候補集 合 Q2D-Web:約1.9億文書、69,721 クエリ、10言語 人間が入力した短い質問だけで検索器を評価しない 多段探索の途中失敗 AgenticRAGTracer:ホップ単位の診断 最終 EM だけでなく、どこで証拠探索が途切れたかを測 る 取り込みから推論まで MLPerf:取り込みと複数ホップ QA を別ワークロー ドで測定 Embedding 速度や LLM tokens/s だけで総体性能 を判断しない テキストと表 T²-RAGBench:検索後の数値推論まで Oracle 文脈の QA だけでは実際の検索失敗を評価で きない 注意 Q2D-Web は開発元の本番クエリ由来で、開発元の検索器に有利な分布(開発元が明記)。MLPerf は探索回数を固定して測るので、Agent の探索回数の変動は測らない。いずれも自社評価と同一視しない 出典: Q2D-Web(Perplexity 開発元資料)、AgenticRAGTracer(ACL 2026)、MLPerf End-to-End RAG(MLCommons)、T²-RAGBench(EACL 2026) Advanced RAG 実践ガイド|新任テックリーダー向け 74
PART 4 セキュリティ・権限・鮮度・費 用 このPartで答えられるようになる問い • 検索結果はなぜ「信頼境界の外」のデータなのか? • 権限・派生データ・命令の分離をどう設計するか? • 削除や更新をどう全派生データに反映するか? • 総費用はどう分解して見積もるか? 品質向上と引き換えに情報漏洩や古い回答を生まないため の設計と、総費用の見積もり方 75
取込 検索 順位付け 生成 評価 運用・安全 検索結果は「信頼境界の外側」から来るデータである 少数の悪性文書の注入で、指定した誤回答を誘導できる。攻撃面はコーパス・検索器・生成器のすべてにある 5件 → 90% コーパス 悪性文書の注入・改ざん、編集可能な Wiki への埋め込み命令 検索器 検索されやすいよう最適化された文書、索引の汚染 生成器 取得文書内の命令に従う(間接プロンプトインジェクション※補足) 数百万テキストの DB に標的質問あたり5件注入 した際の攻撃成功率(論文の攻撃条件) 注意 生成器への「注意文」(「文書内の命令に従うな」)だけを安全対策の全体とみなさない。取込・検索・再ランキング・生成・追跡の各段階 で設計する 出典: PoisonedRAG(USENIX Security 2025)、Retrieved But Not Reliable(RAG セキュリティサーベイ, arXiv:2608.24977) Advanced RAG 実践ガイド|新任テックリーダー向け 76
取込 検索 順位付け 生成 評価 運用・安全 運用要件①:5つの設計原則 引用論文が対策の完全性を証明したものではないが、本番運用の最低要件として設計に組み込む 権限 検索前に利用者・テナント・文書権限で候補を制限し、本文を返す直前にも再確認。権限境界をまたぐ要約・グラフには機密 が残り得る 派生データ 要約・Contextual 説明・グラフ・Embedding・検索/回答キャッシュを原文の版・ACL に紐づけ。原文削除後に派生情 報が残らないかテスト 命令の分離 取得文書の中の命令をシステム指示やツール実行権限として扱わない。Agent のツールは最小権限、検索・読取と外部送 信・更新を区別 鮮度 取得日時・索引日時・文書更新日・施行日/有効日を区別。「質問時点に有効な情報」と「新しく書かれた情報」を混同しない 検証 悪性文書・偽の引用・古いが関連性の高い文書・権限変更直後のキャッシュを含む攻撃・回帰セット。ログ自体の機密性と保 存期間も制御 出典: 元レポート「検索結果は信頼境界の外側から来るデータである」(本レポートの提案する運用要件) Advanced RAG 実践ガイド|新任テックリーダー向け 77
取込 検索 順位付け 生成 評価 運用・安全 運用要件②:ACL を検索境界に組み込む 権限は「回答後のフィルタ」ではなく「検索の条件」。そして返却直前にもう一度確認する 利用者(認証済み) 関門①:検索時 ACL 条件(テナント・権限・ 版・有効日) 検索・再ランキング・生成 ポストフィルタの問題(補足) 関門②:返却直前の再認可 派生物も機密になり得る • 上位 k 件の多くが権限外だと根拠不足 • 権限をまたいだ全社要約・グラフに機密が残る • 利用者ごとに検索品質が大きく変わる • 要約・グラフの作成範囲を権限境界に合わせる • 権限外文書の存在自体が推測される恐れ • キャッシュは利用者・権限単位で分離 リーダーの視点 ACL は後付けできない。PoC 段階から「権限付きで動く」ことを要件にし、セキュリティ部門のレビューを早期に受ける 出典: 元レポート(採用レーダー Adopt:ACL・出所・版を検索境界に組み込む)/ポストフィルタの問題は補足 Advanced RAG 実践ガイド|新任テックリーダー向け 78
取込 検索 順位付け 生成 評価 運用・安全 運用要件③:鮮度と削除の伝播 原文を削除・更新しても、埋め込み・要約・グラフ・キャッシュに古い情報が残る。伝播を設計しテストする チャンク・埋め込み グラフのノード・エッジ Contextual 説明 検索キャッシュ 原文の削除・更新 測る指標 • 削除反映時間 • 更新反映時間 • 残存検出テスト 階層要約(RAPTOR) 回答キャッシュ すべて原文の版・ACL に紐づけ、失効を連鎖させる 区別すべき4つの時刻 取得日時 索引日時 文書更新日 施行日・有効日 いつ原本を取り込んだか いつ索引に反映したか いつ内容が書き換わったか いつからいつまで有効か 出典: 元レポート「セキュリティ・権限・鮮度・運用費用」「実装上の重要な区別」 Advanced RAG 実践ガイド|新任テックリーダー向け 79
取込 検索 順位付け 生成 評価 運用・安全 コストは検索・生成だけでなく「再構築」を含める 期間あたり総費用を分解して測る。更新が多い用途では索引・要約・グラフの再計算が支配的になり得る C期間 = C取込+C再索引+Cストレージ + N問合せ×(C検索+C再ランク+Cエージェント+C生成+C検証) + C評価+C運用 索引側(固定・更新連動) Contextual 説明・グラフ抽出・要約は LLM を大量に呼ぶ。更新のたびに再計算 問合せ側(件数比例) Agent の反復・再ランキング・検証は1問あ たり費用と p95 遅延を押し上げる 評価・運用 人手ラベル、評価器の実行、監視・障害対応 。見積もりから漏れやすい リーダーの視点 Agentic・Graph 方式の追加判断は、成功した少数ケースではなく、問い合わせ分布全体の費用と長尾遅延で行う 出典: 元レポート「コストは検索・生成だけでなく再構築を含める」、HippoRAG 2、GraphRAG Global Search 公式仕様 Advanced RAG 実践ガイド|新任テックリーダー向け 80
PART 5 参照アーキテクチャとロー ドマップ このPartで答えられるようになる問い • どんなコンポーネントに責務を分けるか? • 制御ループはどう実装するか? • 各手法の採用判断(Adopt / Trial / Assess / Hold)は? • どの順序で導入し、何を条件に次へ進むか? 通常経路を短く保ち、高度な検索を交換可能にし、安全性・評 価・版管理を全経路で共通化する 81
取込 検索 順位付け 生成 評価 運用・安全 参照アーキテクチャ:9つのコンポーネント 論文実装の転載ではなく元レポート独自の参照設計。高度な検索を交換可能にし、安全・評価・版管理を共通化 Source Registry Query Orchestrator Evidence Store 原本・版・ACL・有効期間・削除状態 経路選択(通常・全体要約・多段・画像)と予算制御 取得済み証拠・主張との対応・未解決項目 Document Processor Retrieval Gateway Answer & Verifier 構造解析・表・画像・原文位置の保持 認証済みの検索・読取、時点制約、再認可 引用付き回答・主張支持・数値・引用先の検証 Index Builder Candidate Ranker Evaluation & Trace Sparse/Dense・任意の階層・グラフ索引と派生関係 候補融合・再ランキング・重複/多様性制御 バージョン固定・比較実験・コスト・失敗分析 取込系 問合せ制御・検索系 証拠・回答・評価系 ポイント すべての検索・読取を Retrieval Gateway 経由にすると、新しい検索方式を足しても権限制御が漏れない 出典: 元レポート「推奨する責務分離」 Advanced RAG 実践ガイド|新任テックリーダー向け 82
取込

検索

順位付け

生成

評価

運用・安全

制御ループの疑似コード(TypeScript 風)
完成コードではなく制御責務を示す疑似コード。verify・assessCoverage 自体も評価・較正が必要
async function answer(question: string, ctx: QueryContext) {
const plan = await classifyTask(question);
// ルーティング
const state = createEvidenceState(question);
const budget = createBudget(ctx);
// 外部で予算制御
while (budget.canContinue()) {
const action = await chooseAction(plan, state);
if (action.kind === "stop") break;
const cands = await gateway.authorizedSearch({ query: action.query, context: ctx });
const ranked = await rerank(question, cands);
state.add(await gateway.authorizedRead(selectUnderTokenBudget(ranked, budget), ctx));
const coverage = await assessCoverage(question, state); // 充足判定
if (coverage.sufficient || state.noUsefulProgress()) break;
}
if (!state.canSupportAnswer()) return abstainWithReason(state, budget);
const draft = await generateWithCitations(question, state.evidence);
const result = await verifyClaimsAndCitations(draft, state.evidence);
if (!result.passed) return restrictOrAbstain(draft, result);
await gateway.reauthorize(state.evidence, ctx); // 処理中の権限失効に備える
return finalize(draft, state, budget);
}

権限付き検索・読取
すべて gateway 経由

外部予算と停止
充足 or 進捗なしで抜ける

理由付き棄権
支えられないなら答えない

検証→再認可→返却
最後にもう一度権限確認

出典: 元レポート「TypeScript風の制御例」(抜粋・簡略化)
Advanced RAG 実践ガイド|新任テックリーダー向け

83
取込 検索 順位付け 生成 評価 運用・安全 実装上の4つの重要な区別 混同するとバグではなく「設計上の事故」になる4つの境界線 検索用表現 ≠ 根拠 HyDE 文・要約・Contextual 説明は検索補助。原文と同じ証拠 として扱わない 索引更新 ≠ 回答更新 新文書を追加しただけで、古いキャッシュや階層要約が無効化さ れたとみなさない モデル推論 ≠ 決定的制約 ACL・予算・外部アクセス許可・削除状態は LLM の判断だけに任 せない 回答生成 ≠ 検証 検証器の同意は保証ではない。評価器と回答器が同じ誤解を共有 する場合を人手確認と反例で検出 出典: 元レポート「実装上の重要な区別」 Advanced RAG 実践ガイド|新任テックリーダー向け 84
取込 検索 順位付け 生成 評価 運用・安全 技術採用レーダー:全体像 想定用途は「企業内の権限制御された文書 QA」。元レポート独自の判定(Thoughtworks 自身の判定ではない) Adopt Trial Assess Hold 標準設計に組み込む 実データで限定導入 研究・検証 標準方針として避ける • 構造を保つ取込+原文追跡 • Contextual Retrieval • Search-R1 等の RL 学習 • BM25+Dense の併用評価 • Late Chunking • 強いコンテキスト圧縮 • 候補検索と再ランキングの分離 • クエリ書換・HyDE・質問分解 • 引用検証と検索・回答の分離評 価 • RAPTOR/階層要約 • ACL・出所・版を検索境界に • 予算制御付き Agentic RAG • 全問への無制限な反復検索・グ ラフ化 • 用途限定 GraphRAG • ColPali 系の視覚検索 • RAFT 等の検索文脈利用学習 出典: 元レポート「技術採用レーダー」 Advanced RAG 実践ガイド|新任テックリーダー向け 85
取込 検索 順位付け 生成 評価 運用・安全 採用レーダー詳細①:Adopt Adopt の5項目は「どのプロジェクトでも最初に整える基盤」。高度化の前提条件になる 手法・設計 効果を期待する条件と根拠 構造を保つ文書取り込み+原文追跡 表・図・レイアウトを無視したテキスト化では失われる情報がある。抽出方式とページ画像検索を用途で分 ける BM25+Dense の併用評価 型番・固有名詞・自然言語の言い換えを含む検索を単一表現に依存させない。多機能検索を統合する BGE-M3 も候補 候補検索と再ランキングの分離 広い候補集合から精密に選ぶ。ただし特定領域での逆効果を回帰評価で検出する 引用検証と検索・回答の分離評価 正しく答えることと正しく引用することは別に測る。自動評価は人手ラベルで較正する ACL・出所・版を検索境界に組み込む RAG には知識汚染の攻撃面があり、権限を無視した索引設計は避けるべきという設計判断 出典: 元レポート「技術採用レーダー」(ACL 2026 文書 MM-RAG サーベイ、BEIR、BGE-M3、BRIGHT、ALCE、ARES、PoisonedRAG、RAG セキュリティサーベイ) Advanced RAG 実践ガイド|新任テックリーダー向け 86
取込 検索 順位付け 生成 評価 運用・安全 採用レーダー詳細②:Trial・Assess・Hold Trial 以降は「該当する失敗が多いと分かったとき」に限定導入する。条件を満たさなければ入れない 判定 手法・設計 効果を期待する条件 Trial Contextual Retrieval チャンクの企業名・時点・主題が抜け落ちる文書。改善値は開発元評価 Trial Late Chunking 多数の文書から探す検索で文脈を補う場合。1 文書の中を探す用途では不利(チャンク同士が似る) Trial クエリ書換・HyDE・質問分解 質問と根拠文書の表現が離れる場合。生成した仮説は証拠と分離 Trial RAPTOR/階層要約 長文の抽象的理解と具体的根拠の両立。要約の誤りと更新波及に注意 Trial 用途限定 GraphRAG 全体要約ならコミュニティ要約、多段 QA なら経路探索など目的で選ぶ Trial 予算制御付き Agentic RAG 複数段の探索や読取粒度の選択が必要な質問。停止判断も評価対象 Trial ColPali 系の視覚検索 図表・スライド・スキャン PDF が主対象。画像索引の容量も測る Trial RAFT 等の検索文脈利用学習 固定的な専門領域で、文書を与えてもモデルが使いこなせない場合 Assess Search-R1 等の RL 学習 独自の検索方策を学習する便益が学習・更新費用を上回る場合 Assess 強いコンテキスト圧縮 トークン削減が必要で、数値・否定・条件の脱落を検出できる場合 Hold 全問への無制限な反復検索・グラフ化 反復や構造化を目的にしない。非一貫な効果・前処理費用・停止失敗 出典: 元レポート「技術採用レーダー」 Advanced RAG 実践ガイド|新任テックリーダー向け 87
取込 検索 順位付け 生成 評価 運用・安全 導入ロードマップ:ゲート条件で次に進む 期間や人数を一律に決めるものではない。各段階の「次へ進む条件」を満たしたら進み、不要な段階は省く 文書品質・評価セット・Oracle Context・Dense/BM25 比較 1. 基準づくり 2. 検索改善 Hybrid・再ランキング・メタデータ・親子検索 3. 文脈改善 4. 用途別分岐 Contextual Retrieval・Late Chunking・長めの読取 RAPTOR・用途限定 GraphRAG・視覚検索・予算付き Agent 5. 学習投資 6. 本番最適化 RAFT・検索方策 RL・専門評価器 キャッシュ・圧縮・並列化・配置最適化 ゲート:原本不存在・検索失敗・読解失敗を分離できる ゲート:同一条件で重要カテゴリとコストの改善を確認 ゲート:文脈欠落が主要原因と確認、悪化したケースも検知で きる ゲート:対象質問群で単純方式を上回る便益を確認 ゲート:学習データ・更新運用・報酬品質を継続管理できる ゲート:品質・権限・鮮度を保って総費用か遅い側の応答時間 を改善 出典: 元レポート「導入ロードマップと選定指針」 Advanced RAG 実践ガイド|新任テックリーダー向け 88
取込 検索 順位付け 生成 評価 運用・安全 用途別の初期方針 各手法の対象課題に基づく設計仮説。本番採用前に自社データで検証する 社内規程・FAQ 権限・時点付き Hybrid + 再ランキング 技術文書 階層構造の保持 + 親子検索 調査横断の全体要約 コミュニティ要約(GraphRAG Global) 多段の事実 QA 質問分解 + 限定的(予算付き)Agent 図表主体の PDF ページ画像検索 + テキストの併用 出典: 元レポート「導入ロードマップと選定指針」 Advanced RAG 実践ガイド|新任テックリーダー向け 89
PART 6 テックリーダーの実践 このPartで答えられるようになる問い • リーダーが担う責務の全体像は? • 最初の 90 日で何をするか? • 「精度は何%?」とどう対話するか? • 典型的なアンチパターンをどう避けるか? 技術を理解した上で、チーム・ステークホルダー・リスクを動か してプロジェクトを前に進める(本 Part は主に補足) 90
補足 取込 検索 順位付け 生成 評価 運用・安全 テックリーダーの責務マップ 「一番詳しい実装者」ではなく「判断の質と速度を上げる人」。5つの責務を持つ 技術判断 失敗原因に基づく手法 選定。採否を ADR に 記録 評価基盤 評価セット・層別指標・ 実験手順を整備し、全判 断を通す リスク管理 権限・汚染・鮮度・コスト を設計段階から組み込 む 合意形成 期待値管理。業務影響 に翻訳して採否を説明 育成 数字の読み方・診断の型 をチームに浸透させる リーダーの視点 迷ったら「この判断は評価で検証できるか?」「失敗したとき原因を特定できるか?」を問う Advanced RAG 実践ガイド|新任テックリーダー向け 91
補足 取込 検索 順位付け 生成 評価 運用・安全 最初の 90 日プラン(目安) 最初の1か月は「作る」より「測れるようにする」。高度化は失敗の内訳が見えてから Day 1–30 Day 31–60 Day 61–90 測れるようにする 基盤を固める 的を絞って高度化 • 代表文書の取込品質を目視確認 • Hybrid(RRF)・再ランキング導入 • 内訳から選んだ高度化を1〜2個 Trial • 業務担当者と評価セット初版(カテゴリ付 き) • メタデータ条件・親子検索 • ルーティングの要否判断 • 層別指標のダッシュボード • 権限・削除反映・攻撃回帰テスト • Oracle・Dense・BM25 のベースライン • 失敗分析を週次で回す • 本番監視とトレース • メタデータ・ACL スキーマの設計レビュー • 費用・p95 遅延の計測開始 • ステアリングへゲート達成を報告 • 失敗の内訳を初回レポート Advanced RAG 実践ガイド|新任テックリーダー向け 92
補足 取込 検索 順位付け 生成 評価 運用・安全 意思決定の型:仮説 → 最小変更 → 層別測定 → 記録 すべての技術判断を同じ型で回し、ADR(Architecture Decision Record)に残す ①仮説 ②最小変更 失敗事例から原因を推定 効く手を1つだけ入れる ③層別測定 同一条件で段階・カテゴリ 別に ④判断 ⑤記録 改善・劣化・費用・遅延 ADR に理由と数字 例:ADR-012 BM25 併用の採用 • 仮説:型番・条項番号を含む質問の検索失敗が多いのは、Dense が文字列一致を捉えないため • 変更:BM25(形態素解析+型番用の分割規則)を追加し RRF(c=60)で融合 • 結果:型番カテゴリの Recall@20 が改善、言い換えカテゴリは劣化なし、p95 遅延の増加は許容範囲(※数値は自社評価で記入) • 判断・次の一手:採用。残る失敗は「主語・時点不明」→ 見出し付加と親子検索を次に検証 Advanced RAG 実践ガイド|新任テックリーダー向け 93
補足 取込 検索 順位付け 生成 評価 運用・安全 ステークホルダーとの対話:「精度は何%?」にどう答えるか 単一の数字で約束しない。カテゴリ別・層別の数字と「棄権」を含めて、業務影響の言葉で語る 対話の例 合意すべき指標のセット 業務部門:「精度 90% を目指してください」 リーダー:「規程の単純な質問は 90% を目標にします。一方、 例外条件を含む質問は現状 6 割で、誤答時の影響が大きいの で、ここは『分からない場合は人事窓口へ案内』を優先させてく ださい。権限外の情報が出る件数は 0 を必須条件にします」 • カテゴリ別の正答率(単純/例外/数値…) • 根拠不在時の棄権の適切さ • 重大誤答の件数(業務部門と定義) • 安全性の必須条件(権限外露出 0 等) • 応答時間(p95)と 1 問あたり費用 リーダーの視点 「何%」ではなく「どの質問で、どんな誤りが、何件減るか」 で語ると、期待値と投資判断が揃う Advanced RAG 実践ガイド|新任テックリーダー向け 94
補足 取込 検索 順位付け 生成 評価 運用・安全 体制と役割:誰が何に責任を持つか RAG の品質はモデルだけでなく、データ・検索・評価・安全の各責任者の連携で決まる 役割 主な責任 主に関わるコンポーネント データ/取込エンジニア 構造化取込、メタデータ・版・ACL の整備、削除伝播 Source Registry、Document Processor 検索エンジニア BM25・Dense・融合・再ランキング、索引の性能と容量 Index Builder、Candidate Ranker LLM アプリエンジニア オーケストレーション、引用付き生成、検証、ルーティング Query Orchestrator、Answer & Verifier 評価担当 評価セット・層別指標・実験基盤・評価器の較正 Evaluation & Trace 業務担当者(SME) 正解と根拠のラベル付け、重大誤答の定義、受入判断 評価セット セキュリティ・法務 ACL 設計レビュー、外部検索可否、ログ保存期間 Retrieval Gateway SRE/インフラ p95/p99・費用・索引更新の監視、容量計画 全体 Advanced RAG 実践ガイド|新任テックリーダー向け 95
補足 取込 検索 順位付け 生成 評価 運用・安全 論文・ベンダー資料を読むときのチェックリスト Part 1 の「数字の読み方」を、レビューの場でそのまま使える10の質問にしたもの 1 測っているのは検索か、回答か、引用か? 6 誰が評価したか(開発元・第三者)?データは公開か? 2 EM・F1・Contain・LLM 判定・選好勝率のどれか? 7 評価データの分布は自社業務に近いか(言語・文書種別)? 3 絶対差か、相対改善か? 8 カテゴリ別の劣化は報告されているか? 4 比較相手は強いベースライン(BM25+再ランキング等)か? 9 索引・推論の費用と遅延は示されているか? 5 回答モデル・プロンプト・トークン予算は揃っているか? 10 最新モデルでも再現するか(過去モデルでの結果か)? Advanced RAG 実践ガイド|新任テックリーダー向け 96
補足 取込 検索 順位付け 生成 評価 運用・安全 アンチパターン集:よくある失敗と処方箋 元レポートの原則に反する 6 つの要約。原因・根拠・事例は Part 7 で詳しく扱う いきなり GraphRAG・Agent 評価なしのチューニング 全質問を Agentic に 基盤と評価なしで複雑化 チャンク長やプロンプトを感覚で調整 費用・遅延増、過剰探索で迷走 処方箋:Adopt の5項目から始める 処方箋:Oracle と層別指標を先に作る 処方箋:ルーティングで複合質問だけ 生成物を証拠に混入 ACL を後付け 平均値だけで判断 HyDE 文・要約を根拠として引用 PoC は全権限で動かし本番で破綻 カテゴリ劣化・p99 悪化を見逃す 処方箋:型を分け、引用は原文のみ 処方箋:初期スキーマに ACL・版・有効日 処方箋:カテゴリ別・長尾・重大誤答を見る Advanced RAG 実践ガイド|新任テックリーダー向け 97
PART 7 アンチパターン大全 このPartで答えられるようになる問い • なぜ「全データを 1 つのスキーマに」はうまくいかな いのか? • 汎用リランカーや大きな top-k はいつ逆効果にな るのか? • 規模が大きくなると何が壊れるのか? • 全社汎用 RAG は実際にどう作られているのか? データ・検索・システムと規模の 3 層で、よくある失敗を「な ぜ失敗するか・根拠・代わりにどうするか」で整理し、全社横断 RAG を乗り越えた事例から設計の型を学ぶ 98
補足 取込 検索 順位付け 生成 評価 運用・安全 アンチパターンの全体地図:3 つの層 失敗の多くはモデルではなく、データの扱い・検索の組み立て・システムと組織の進め方にある データ・索引 検索・生成 システム・組織・規模 • 全ソースを 1 つのスキーマ・分割規則に • 集計・列挙を top-k で答える • 全社基盤を最初に作るビッグバン • 固定長の一律分割、ベクトル検索だけ • 汎用リランカー 1 つを全ドメインへ • 全データを 1 つのベクトル DB に集約 • 表や帳票を文章として埋め込む • top-k と文脈は多いほど良い • 権限を後段フィルタだけで処理 • OCR 品質を確かめずに投入 • 根拠が足りなくても答えさせる • 平均指標だけで判断 • 版・有効期間・権限を持たない • 全質問をエージェント・GraphRAG に • コーパスが増えても品質が保てる • 要約と原文を区別せず混ぜる • LLM 評価・クエリ書換の過信 • 取得文書を信頼、フィードバックなし • 詳細:次の 2 枚 • 詳細:その後の 5 枚 • 詳細:その後の 3 枚と事例 NVIDIA の構築報告:生成の品質は検索の関連度に強く依存し、検索の関連度はメタデータ・分割・クエリの言い換えに依存する Advanced RAG 実践ガイド|新任テックリーダー向け 99
補足 取込 検索 順位付け 生成 評価 運用・安全 「万能スキーマ」の幻想:なぜ全データを 1 つの型に流し込めないのか データの種類ごとに「何を関連とみなすか」が違う。1 つの分割規則・埋め込みでは、どれかが必ず崩れる アンチパターン • 全ソースを同じスキーマ・同じ分割・同じ埋め込みに • 「揃えれば検索で何とかなる」と考える • 改善を全体平均で判断する 代わりに • ソースの種類ごとに取込・分割・検索方式を分ける • 共通にするのは最小の契約(ID・版・権限・有効期間・原文位置) • ソースの選択(ルーティング)を前段に置く 実践編(本資料の FMEA ケーススタディ、正答数/問題数) 結果 同じ構造化取込(段落ごとに分割)を全ソースに FMEA の Excel は 2/8 → 7/8 に改善、特許は 4/6 → 1/6 に 悪化(名称と番号が別チャンクに) チャンク先頭の見出しにファイル名を使うと 38 → 34 問(ファイル名の型番に引かれ、答えのない取説が上位に) 出典: NVIDIA「FACTS About Building RAG-based Chatbots」(arXiv:2407.07858)、Seven Failure Points(CAIN 2024)、実践編ケーススタディ(FMEA 作成支援、 OpenSearch で実測) Advanced RAG 実践ガイド|新任テックリーダー向け 100
補足 取込 検索 順位付け 生成 評価 運用・安全 データ・索引のアンチパターン一覧 どれも「取込の段階で失った情報は、後段のどんな工夫でも取り戻せない」という同じ原理に帰着する アンチパターン なぜ失敗するか 代わりにどうするか 固定長で一律に分割して終わり 見出し・文書名が失われ、チャンク単体で意味を誤る 見出し・文脈を付ける。サイズは評価セットで探索 ベクトル検索だけ 型番・固有名詞・完全一致に弱い BM25+Dense のハイブリッドを初期構成に 表・帳票を文章として埋め込む 値と列名・行の対応が切れる 行単位で「列名: 値」。集計は構造化検索へ OCR の品質を確かめずに投入 誤読と表崩れが検索と生成に連鎖 取込に品質ゲート。原本ページへのリンク 版・有効期間・権限を持たない 新旧の規程を両方根拠に矛盾した回答 必須メタデータに。古い版は無効フラグ 要約と原文を区別せず混ぜる(※) 要約の誤りが「根拠」として引用される 要約は探す入口、引用は原文だけ ※ 直接の定量研究は未確認。設計上の予防策として推奨 出典: Anthropic Contextual Retrieval、Is Semantic Chunking Worth the Computational Cost?(arXiv:2410.13070)、OHRBench(arXiv:2412.02592)、 OWASP LLM08:2025、Seven Failure Points Advanced RAG 実践ガイド|新任テックリーダー向け 101
補足 取込 検索 順位付け 生成 評価 運用・安全 集計・列挙を top-k で答えようとする 「何件?」「全部挙げて」は、上位 k 件を抜き出す仕組みでは構造的に答えられない。質問の型で振り分ける 質問の型を判定 事実照会 列挙・集計 全体要約 右の 3 つのどれか 1 つへ ハイブリッド+再ランキング 絞り込み・セマンティックレイヤー* コミュニティ要約など *売上などの指標の定義を一か所にまとめた層(dbt、Cube など)。Hold=Radar で「新規採用を控える」判定 1/3 → 3/3 40% → 90% 実践編:該当事例を全部挙げる質問。上位 5 件では 3 件中 1 件、型番で絞り込むと 3 件とも Pinterest:表の説明文を索引に含めると「使う表 を探す」ヒット率が最大 90% 注意 ただし Text to SQL を監督なしで使 うのも危険。Thoughtworks Radar Vol.33 は Hold とし、人のレビューと セマンティックレイヤー経由を推奨 リーダーの視点 「何件?」「全部?」という質問が評価セットに何割あるかを最初に数える。多ければ RAG ではなく構造化検索の案件 出典: GraphRAG(arXiv:2404.16130)、Thoughtworks Technology Radar Vol.33(2025-11、Text to SQL を Hold)、Pinterest Engineering「How we built Text-to-SQL at Pinterest」、実践編ケーススタディ Advanced RAG 実践ガイド|新任テックリーダー向け 102
補足 取込 検索 順位付け 生成 評価 運用・安全 検索・生成のアンチパターン一覧 「足せば良くなる」「多いほど良い」という直感が、検索と生成の段で最も裏切られる アンチパターン なぜ失敗するか 代わりにどうするか 汎用リランカー 1 つを全ドメインへ 学習領域外では順位を壊す ドメイン別の評価セットで選び、件数も調整 top-k・文脈は多いほど良い 中央の情報が読まれず、紛らわしい文書に誤導される k をモデル×タスクで測る。絞ってから渡す 根拠が足りなくても答えさせる 大きなモデルほど控えずに誤答する 十分性の判定と、控える経路を設計に入れる 全質問をエージェントの反復に 単純な質問で費用と遅延が無駄に増える 複雑さで振り分け、複雑な質問だけ 何にでも GraphRAG 索引の構築費が大きく、更新に弱い 全体要約・関係探索に限定。軽量版から 人と突き合わせない LLM 評価 順序・長さ・自己選好のバイアス 少数の人手ラベルで一致率を測ってから使う 書き換えで制約が落ちる(※) 日付・否定・型番が消える 制約は構造化フィルタとして保持 ※ 一次資料の定量証拠は未確認。設計上の予防策として推奨 出典: BRIGHT(ICLR 2025)、Lost in the Middle(TACL 2024)、Long-Context LLMs Meet RAG(arXiv:2410.05983)、Sufficient Context(ICLR 2025)、 Adaptive-RAG(NAACL 2024)、LazyGraphRAG(Microsoft Research)、Judging LLM-as-a-Judge(NeurIPS 2023) Advanced RAG 実践ガイド|新任テックリーダー向け 103
補足 取込 検索 順位付け 生成 評価 運用・安全 汎用リランカーの罠:学習領域の外では順位を壊す 英語 Web で学んだ小型リランカーは、推論が要る検索で BM25 未満に。並べ替える件数が多いほど悪化 BRIGHT:BM25 の上位 N 件を並べ替えた結果(nDCG@10) 決めるべきこと 20 17.4 18 16 • どのリランカーか(言語・領域) 14.3 • 何件を並べ替えるか 13.1 14 • どのドメインに入れるか 12 10 8.3 8 ポイント 6 効く例もある:強い商用・日本語モデル × 社内 FAQ では改善(DeNA は上位 100 件を 20 件に、実践編は 40 → 44 問)。差はモデルとタ スク 4 2 0 BM25 のみ MiniLM 上位10件 MiniLM 上位100件 GPT-4 再ランキング nDCG@10=上位 10 件の並び順の良さ(高いほど良い) 出典: BRIGHT(arXiv:2407.12883、ICLR 2025)、Drowning in Documents(arXiv:2411.11767、SIGIR 2025 ReNeuIR)、DeNA Engineering Blog(2025-11) Advanced RAG 実践ガイド|新任テックリーダー向け 104
補足 取込 検索 順位付け 生成 評価 運用・安全 文脈は多いほど良い、ではない 件数を増やすと品質はいったん上がり、やがて下がる。どこまでが上り坂かはモデル×タスク次第なので自社で測る DeNA:20 件までは上り坂(取得件数と精度 %) さらに増やすと下がる証拠 80 69 70 60 61 • 中央にある情報は読まれにくい(Lost in the Middle) • 件数を増やすと品質は上がってから下がる。主因は紛らわしい文書 54 50 • Databricks:入力長のピークは gpt-4-turbo で 16k トークン、 Llama-3.1-405b で 32k 付近 40 • Chroma:18 モデルすべてで長い入力ほど信頼性が低下 30 20 10 0 5件 10 件 20 件 「k を増やして解決」には上り坂と下り坂がある。5・10・20 件…と段階的に測り、頭打ちの点を費用・遅延と並べて決める 出典: Lost in the Middle(TACL 2024)、Long-Context LLMs Meet RAG(arXiv:2410.05983)、Databricks Blog「Long Context RAG Performance of LLMs」、 Chroma Research「Context Rot」、DeNA Engineering Blog、実践編ケーススタディ Advanced RAG 実践ガイド|新任テックリーダー向け 105
補足 取込 検索 順位付け 生成 評価 運用・安全 アンチパターン:答えない経路がない/何でもエージェント・グラフ 根拠が足りないときに控える経路を作る。高価な機構は、必要な質問にだけ振り分ける 根拠が足りなくても答えさせる • 大きなモデルほど控えずに誤答 • 控える方式で、答えた問の正答率 +2〜 10%(控えない場合比) • → 十分性の判定と「答えない」経路 全質問をエージェントに 何にでも GraphRAG • 複雑さで振り分けると効率と精度が両方 改善(Adaptive-RAG) • 索引の構築で LLM を大量に呼ぶ • マルチエージェント:社内評価 +90.2%( 単一比)、トークンは通常チャットの約 15 倍 • → 全体要約・関係探索に限定( Thoughtworks Radar では Trial= 試行推奨) • 軽量版は構築費がフル版の 0.1% • → 複雑な質問だけ リーダーの視点 高価な機構は「入れるか」ではなく「どの質問に回すか」で決める。先に質問の型と難しさを数え、振り分けの規則を作る 出典: Sufficient Context(arXiv:2411.06037、ICLR 2025)、Adaptive-RAG(arXiv:2403.14403、NAACL 2024)、Microsoft Research「LazyGraphRAG」、 Anthropic「How we built our multi-agent research system」 Advanced RAG 実践ガイド|新任テックリーダー向け 106
補足 取込 検索 順位付け 生成 評価 運用・安全 システム・組織・規模のアンチパターン一覧 技術選定より前の「進め方」の誤りは、後から直すほど高くつく アンチパターン なぜ失敗するか 代わりにどうするか 全社基盤を最初に作るビッグバン 検証は運用中にしかできず、評価の的がない 価値の高い 1〜2 ユースケースを縦に作り切る 全データを 1 つのベクトル DB に集約 鮮度・再索引・権限の二重管理 ソースごとに同期型と連合型を選ぶ 権限を後段フィルタだけで処理 漏洩リスクと、厳しい条件での再現率の急落 検索前・検索中に絞る。導入前に過剰共有を棚卸し 平均指標だけで判断 特定の質問型の大きな失敗が隠れる ユースケース×質問型の層別と最悪ケース コーパスが増えても品質が保てる 似て非なる文書が上位に増える 規模を変えて劣化を測ってから全量投入 取得文書を信頼できるデータとして扱う 文書内の命令がツール操作・漏洩に ソース認証、最小権限、重要操作は人の承認 クエリを見る前に保存基盤を選ぶ 失敗の多くは検索とデータの問題 実際のクエリを分類してから方式を決める フィードバックの経路がない 頑健性が育たない 低評価・控えた回答を評価セットへ戻す 出典: Seven Failure Points(CAIN 2024)、OWASP LLM08:2025、Weaviate Docs「Filtering」、Greshake et al.(arXiv:2302.12173)、PoisonedRAG(USENIX Security 2025)、Thoughtworks Technology Radar Vol.34 Advanced RAG 実践ガイド|新任テックリーダー向け 107
補足 取込 検索 順位付け 生成 評価 運用・安全 規模の罠:コーパスが増えるほど検索は劣化する 文書が 100 倍になると、同じ k でも正解が上位に残りにくい。Dense は特に速く劣化する Onyx:コーパス規模と Recall@10(%) 起きること 100 90 85.0 • 似て非なる文書が上位に入り込む 81.3 • Dense は BM25 より速く劣化(Reimers & Gurevych 2021) 80 70 • 規模が増えるほど混入を検査しにくい。数百万件中の毒入 り 5 件で攻撃成功 90% 55.7 60 50 40.7 40 30 リーダーの視点 PoC の規模で品質を約束しない。コーパスの一部を 10 倍・100 倍と増やして劣化曲線を測り、ハイブリッ ド・k の調整・索引の分割を計画に入れる 20 10 0 BM25 Dense 5,000 件 51 万件 出典: Reimers & Gurevych「The Curse of Dense Low-Dimensional Information Retrieval for Large Index Sizes」(ACL 2021)、Onyx Blog「Retrieval corpus scaling」(ベンダー、単一データセット)、PoisonedRAG(USENIX Security 2025) Advanced RAG 実践ガイド|新任テックリーダー向け 108
補足 取込 検索 順位付け 生成 評価 運用・安全 中央集約(同期型)か、連合(都度取得)か 同期型=取り込んで索引を作る。連合型=元システムの検索 API に都度問い合わせる。ソースごとに選ぶ 同期型(索引を作る) 連合型(都度取得) 長所 統合した順位付け、閲覧・編集などの利用シグナルを使える、速 い 鮮度が高い、権限が元で効く、複製しない 短所 ACL 同期と再索引の運用負荷、鮮度の遅れ 横断の順位付けが難しい、遅延、検索語が外部サービスへ送ら れる 向くデータ 静的な知識(規程・マニュアル・過去事例) 動的なデータ、規制対象のデータ 例 Glean、Notion、Microsoft 同期コネクタ Slack の外部検索、Microsoft 連合コネクタ Dropbox Dash の教訓 ツールを増やすと定義が文脈を圧迫し精度低下 → 検索ツールを 1 本に統 合 コード検索は論争中 索引なしで都度 grep(連合型に近い)で足りるとする Claude Code と、 意味検索の索引で精度向上とする Cursor 出典: Google Cloud「Gemini Enterprise: Introduction to connectors and data stores」、Microsoft Learn「Copilot connectors / Federated connectors」、 Slack Engineering、Dropbox Tech Blog、Boris Cherny(X, 2026-02-01)、Cursor Blog「Semantic search」 Advanced RAG 実践ガイド|新任テックリーダー向け 109
補足 取込 検索 順位付け 生成 評価 運用・安全 全社横断 RAG はどう作られているか①:製品の設計 索引は統合でも、取込・権限・鮮度はソース別コネクタで扱う(MCP=LLM が外部ツールを呼ぶ標準) 製品 ソースの扱い 索引・順位付け 報告されている数値(条件) Glean ソース別コネクタで内容・活動・ID・権限 グラフ+ベクトル・キーワード・個人化 導入 6 か月で検索品質 +20%(自己申 告) Microsoft 365 Copilot 同期型と連合型(MCP)のコネクタ 組織全体と個人ごとの 2 層の意味索引 公開数値なし Gemini Enterprise エンティティの種類ごとに別データストア 取り込み型と連合型を選択 公開数値なし Amazon Q Business 40 以上のコネクタ、ACL を索引に保持 2025-08 にエージェント型検索を追加 公開数値なし Dropbox Dash 統合索引+グラフ 検索+取得時の分割+再ランキング 95% 超のクエリを 1〜2 秒以内 Notion AI 中央索引、編集を 1 分以内に反映 ベクトル検索 2 年で規模 10 倍、コスト −90% 出典: Glean Docs / Blog、Microsoft Learn(Copilot connectors、Retrieval API)、Google Cloud(Gemini Enterprise)、AWS Docs / Blog(Amazon Q Business) 、Dropbox Tech Blog、Slack Engineering、Notion Blog「Two years of vector search at Notion」 Advanced RAG 実践ガイド|新任テックリーダー向け 110
補足 取込 検索 順位付け 生成 評価 運用・安全 全社横断 RAG はどう作られているか②:自社構築の事例 全社横断に見える成功も、掲載例はいずれも 1 領域から始め、取込・振り分け・評価に投資した 事例 絞った領域 効いた打ち手 報告された結果(条件) Uber(EAg-RAG) セキュリティ・プライバシーの方針文書 40+ 表を正しく取る取込、質問の補完、ソース特定(ルー ティング) 専門家が許容できる回答 +27%、誤った 助言 −60%(相対、100 問+) LinkedIn カスタマーサービスの過去チケット チケットの構造と関係をナレッジグラフに MRR(正解が何位に出るか)+77.6%、 解決時間 −28.6% Pinterest 社内の分析用テーブル 表専用の索引、表ドキュメントの重み付け 検索ヒット率 40% → 最大 90% Grab(Hubble) データカタログ 検索の 75%(完全・部分一致)は従来検索、曖昧な 25% だけ LLM へ クリック率 82% → 94% DoorDash 配達員サポート 2 段のガードレールと LLM 評価 ハルシネーション −90%、重大な問題 −99% 出典: Uber Engineering「Enhanced Agentic RAG」、LinkedIn(arXiv:2404.17723、SIGIR 2024)、Pinterest Engineering、Grab Engineering「Hubble」、 DoorDash Engineering「Dasher support automation」 Advanced RAG 実践ガイド|新任テックリーダー向け 111
補足 取込 検索 順位付け 生成 評価 運用・安全 全社横断 RAG はどう作られているか③:国内の事例 国内でも、対象を段階的に広げた事例、件数と再ランキングを測って決めた事例が公開されている パナソニック コネクト ConnectAI DeNA 社内ヘルプデスク Findout • 公開情報で試行 → 2024-04 から社外 秘の品質管理文書 630 件・11,743 頁 • LLM が 0〜4 点で採点、3 点以上を合 格 • 引用元を表示 • 取得 5/10/20 件で精度 54/61/69% • ConnectAI 全体の削減時間 78.8 万 時間(2025 年度、RAG 単体ではない) • 上位 100 件を再ランキングで 20 件、 階層チャンク 300/1,200 字 参考:富士通・メルカリ(手法の公 開のみ) • 富士通:規則・法令・マニュアルからナレッ ジグラフを自動生成(実運用の数値は未 確認) • メルカリ:エンジニアリング知識を日英ま たいで回答(定量結果なし) ポイント 共通点:小さく始めて対象を広げる/引用元を示す/件数や再ランキングを自分たちの評価で決める 出典: パナソニック コネクト ニュースリリース(2024-06-25、2026-07-29)、DeNA Engineering Blog(2025-11)、富士通 プレスリリース(2024-06)、メルカリ Engineering Blog(2024-12) Advanced RAG 実践ガイド|新任テックリーダー向け 112
補足 取込 検索 順位付け 生成 評価 運用・安全 乗り越えた事例に共通する 6 つのパターン 「汎用の 1 つ」を作るのではなく、絞った用途を評価付きで作り切り、共通部品とルーターで束ねる 1 用途を端から端まで作り切る ユースケースを 1〜2 個に絞り、ゴールデンセットで関門を作る(Uber、パナ ソニック、LinkedIn) ソース別の取込品質 表の抽出、ドキュメント生成、構造の保持。リランカーより前が支配的(Uber、 Pinterest) 索引の持ち方を選ぶ 静的な知識は同期型、動的・規制対象は連合型。ツールは少数に統合( Microsoft、Dropbox) ルーター+専門検索器 ソース特定・質問の種類で振り分け、表・チケット・文書に専用の検索(Uber、 Grab、Pinterest) 権限を考慮した取込 ACL を索引に持つか、ユーザー資格で都度取得(Amazon Q、Glean、 Slack) 評価とフィードバックの常設 LLM 評価器、用途別の指標、利用データの還流(DoorDash、DeNA、 Glean) 出典: 前 3 枚の事例(Uber、LinkedIn、Pinterest、Grab、DoorDash、Glean、Microsoft、Google、Dropbox、Slack、パナソニック コネクト、DeNA)の整理 Advanced RAG 実践ガイド|新任テックリーダー向け 113
補足 取込 検索 順位付け 生成 評価 運用・安全 参照構成:ハブ&スポーク型の社内 RAG ハブ=中央のルーター+共通基盤。スポーク=データ特性ごとの専用検索器。スポーク単位で評価・改善する 規程・マニュアル ハイブリッド+再ランキング 利用者の質問 ルーター 質問の型とソースを判定 各スポークが自分の評価セットを持ち、独立して改善する 表・帳票 セマンティックレイヤー・行単位索引 チケット・不具合 メタデータ+ナレッジグラフ 特許・図面 符号・引用の参照関係のグラフ 動的データ 元システムの API を連合検索 共通基盤:最小の契約(ID・版・権限・有効期間・原文位置)/権限判定/評価とトレース/監視 Advanced RAG 実践ガイド|新任テックリーダー向け 114
補足 取込 検索 順位付け 生成 評価 運用・安全 「特定エージェント専用」と「社内汎用」:最適化の難しさの正体 業務専用の索引は質問と正解が決まるので測って最適化できる。汎用は不可なのでスポーク+ルーターで作る 観点 特定エージェント・業務専用 社内汎用 質問の分布 狭く、安定している 広く、変化する 正解の基準 用途で 1 つに決まる 用途ごとに違う 評価セット 作れる(数十〜百問で効く) 全体を代表するものは作れない リランカー・k・分割 測って最適化できる 平均で最適化すると特定用途で崩れる リーダーの視点 汎用の作り方 「汎用で高精度」を約束しない。「重点用途は評価付きで高精度 、それ以外は探す手助け」と期待値を分けて合意する 重点用途ごとに最適化したスポーク+ルーター。どこにも当たらない質問は 汎用検索で「探す手助け」 Advanced RAG 実践ガイド|新任テックリーダー向け 115
補足 取込 検索 順位付け 生成 評価 運用・安全 対象の規模・範囲別の設計指針 範囲が広がるほど「索引の分け方・振り分け・権限・評価運用」が支配的(過剰共有=見せすぎの権限) 範囲(文書数の目安) 推奨構成 索引の持ち方 評価 主なリスク 単一ユースケース(〜数千) ハイブリッド+再ランキング、構造化 取込 同期型 1 つ 用途の評価セットで最適化 過剰な機構(グラフ・エージェ ント) 部門横断(数万〜数十万) ソース種別ごとの取込+ルーター 同期型を種類ごとに分割 ユースケース×質問型の層別 規模による劣化、表記ゆれ、 権限 全社(数百万〜) ハブ&スポーク、エージェントは複雑 な質問だけ 同期型+連合型の併用 スポーク単位+全体の監視 過剰共有、汚染、鮮度、運用体 制 文書数の区切りは議論のための目安で、厳密な閾値ではない。自社のコーパスで劣化曲線を測って判断する Advanced RAG 実践ガイド|新任テックリーダー向け 116
補足 取込 検索 順位付け 生成 評価 運用・安全 Advanced RAG を語るための 7 つの持論(根拠付き) 会議で問われたときに、根拠を添えて言い切れる形にまとめた 1 RAG の失敗は、まず検索とデータを疑う NVIDIA FACTS、Seven Failure Points、BRIGHT 2 初期構成はハイブリッド+ドメインで検証した再ランキング BRIGHT、Reimers & Gurevych 2021、Anthropic 3 文脈は多いほど良いわけではない。k は測って決める Lost in the Middle、Long-Context LLMs Meet RAG、 Databricks 4 質問の型で振り分ける(集計・全体要約・事実・複雑さ) GraphRAG、Adaptive-RAG、Radar の Text to SQL Hold 5 権限は検索前に効かせ、取得文書は信頼しない OWASP LLM08、PoisonedRAG 6 コーパスは育つほど劣化する。規模を変えて測る Reimers & Gurevych 2021、Onyx 7 全社基盤ではなく 1 ユースケースの評価セットから Seven Failure Points、Uber、パナソニック コネクト Advanced RAG 実践ガイド|新任テックリーダー向け 117
補足 取込 検索 順位付け 生成 評価 運用・安全 自己診断チェックリスト:アンチパターンに陥っていないか 「いいえ」が付いた項目が、次の打ち手の候補。定例のレビューで 1 か月に 1 回見直す 対象のユースケースと評価セットがある 根拠が足りないときに答えない経路がある 質問の型(事実・列挙・要約・多段)を数えた 権限を検索前に効かせている ソースの種類ごとに取込を分けている 版・有効期間を索引に持つ ハイブリッド検索を持っている 規模を変えて劣化を測った 再ランキングをドメインの評価で選んだ 取得文書の命令を実行しない k を測って決めた 低評価の回答を評価セットに戻している Advanced RAG 実践ガイド|新任テックリーダー向け 118
Part 7 の主要出典 • 論文:NVIDIA FACTS(arXiv:2407.07858)/Seven Failure Points(arXiv:2401.05856)/BRIGHT(arXiv:2407.12883)/Drowning in Documents(arXiv:2411.11767)/Lost in the Middle(arXiv:2307.03172)/Long-Context LLMs Meet RAG(arXiv:2410.05983)/ Sufficient Context(arXiv:2411.06037)/Adaptive-RAG(arXiv:2403.14403)/GraphRAG(arXiv:2404.16130)/Judging LLM-as-aJudge(arXiv:2306.05685)/Is Semantic Chunking Worth It?(arXiv:2410.13070)/OHRBench(arXiv:2412.02592)/Reimers & Gurevych(arXiv:2012.14210)/PoisonedRAG(arXiv:2402.07867)/Greshake et al.(arXiv:2302.12173)/LinkedIn KGRAG(arXiv:2404.17723) • 実務・ベンダー:Anthropic Contextual Retrieval・multi-agent research system/Microsoft Research LazyGraphRAG/Databricks Long Context RAG/Chroma Context Rot/Onyx Retrieval corpus scaling/OWASP LLM08:2025/Weaviate Filtering/Thoughtworks Technology Radar Vol.32〜35 • 事例:Glean/Microsoft 365 Copilot(Learn)/Google Gemini Enterprise/Amazon Q Business/Dropbox Dash/Slack/Notion/Uber Enhanced Agentic RAG/Pinterest Text-to-SQL/Grab Hubble/DoorDash/パナソニック コネクト/DeNA Findout/富士通/メルカリ/ Claude Code(Boris Cherny, X)/Cursor Semantic search Advanced RAG 実践ガイド|新任テックリーダー向け 119
取込 検索 順位付け 生成 評価 運用・安全 未解決点と証拠の限界 ここに挙げた点は、論文を読んでも答えが出ない。自社で検証して埋めるべきギャップである 日本語の専門業務 省略表現・社内語彙・表記ゆれ・法令の時点差への効果量は、英語中心 のベンチマークでは確定できない 方式の合成効果 Hybrid・再ランキング・グラフ・Agent・圧縮を重ねた効果は、個別論 文の改善率の加算では推定できない 最新モデルへの移行 過去モデルで有効だった前処理・自己評価が新モデルで同じ効果を持 つとは限らない。検索方式と回答モデルを片方ずつ入れ替えて評価 安全性の保証 引用付与・自己評価・グラフ化だけで正確性や安全性が保証される根拠 は確認できない リーダーの視点 これらをリスクとしてプロジェクト計画に明記し、検証タスクと担当を割り当てる 出典: 元レポート「未解決点と証拠の限界」(BGE-M3、ARES、RAGSearch、A-RAG、ALCE、PoisonedRAG、RAG セキュリティサーベイ) Advanced RAG 実践ガイド|新任テックリーダー向け 120
総括 最も高度な方式を選ぶのではなく、 実測した失敗原因に対して最小限の追加機構を選ぶ 1. 測る 2. 診断する 3. 最小の手を打つ 4. 代償も確認する 検索・読解・引用・権限・鮮度 を分離して測る 根拠不在/検索失敗/利用 失敗に分ける Adopt の基盤 → 該当する Trial を1つずつ 費用・遅延・新たな故障モー ド・安全性 Advanced RAG の進展は「検索器の強化」に留まらず、検索対象の表現・読取粒度・探索順序・停止判断・評価範囲の拡張にある。一方、高 度な分割・グラフ化・反復検索がすべての質問で有利になるわけではない。
付録:用語集① 用語 意味 RAG Retrieval-Augmented Generation。検索した文書を根拠として LLM に回答させる構成 チャンク 索引化・検索の単位に分割した文書の断片 埋め込み(Embedding) 文を意味が近いほど近くなるベクトルに変換したもの Dense 検索 埋め込みベクトルの類似度で検索する方式(バイエンコーダ) BM25 / Sparse 単語の頻度と珍しさに基づく語彙検索。学習型 Sparse は語の重みを学習 ハイブリッド検索 語彙検索と Dense 検索を併用し結果を融合する方式 RRF Reciprocal Rank Fusion。順位の逆数の和で複数の検索結果を融合 再ランキング 候補をクロスエンコーダ等で精密に並べ替える後段処理 Late Interaction トークン単位の複数ベクトルで照合する方式(ColBERT、ColPali) ANN 近似最近傍探索。HNSW・IVF 等で高速に近いベクトルを探す Advanced RAG 実践ガイド|新任テックリーダー向け 122
付録:用語集② 用語 意味 親子検索 小さな単位で検索し、親セクションを読む方式(Small-to-Big) Contextual Retrieval チャンクに LLM 生成の文脈説明を前置してから索引化する方式 Late Chunking 文書全体を文脈化した後にチャンクごとにトークン表現を平均する方式 HyDE 仮想的な回答文書を生成し、その埋め込みで検索する方式 マルチホップ(多段) 中間事実を順に辿らないと答えられない質問・検索 GraphRAG エンティティ・関係のグラフを使う RAG の総称(中身は系統で大きく異なる) Agentic RAG 検索語・粒度・読取範囲・停止条件をモデルが選ぶ RAG Oracle Context 正解根拠を直接与える評価条件。読解側の上限を測る Recall@k / nDCG / MRR 候補の網羅性/順位の質/最初の正解の順位 EM / F1 / 忠実性 完全一致/単語重なり/回答が根拠に支持される度合い ACL Access Control List。文書ごとの閲覧権限 Advanced RAG 実践ガイド|新任テックリーダー向け 123
付録:主要出典① • サーベイ:Huang & Huang, ACM Computing Surveys(dl.acm.org/doi/10.1145/3805774)/Scaling Beyond Context(ACL 2026)/Retrieved But Not Reliable(arXiv:2608.24977) • 検索:BEIR(arXiv:2104.08663)/BRIGHT(arXiv:2407.12883)/BGE-M3(arXiv:2402.03216)/ColBERTv2( arXiv:2112.01488)/RRF(Cormack et al., SIGIR 2009) • チャンク・文脈:Anthropic Contextual Retrieval(anthropic.com/research/contextual-retrieval)/Late Chunking( arXiv:2409.04701)/Beyond Chunk-Then-Embed(arXiv:2602.16974) • クエリ:HyDE(arXiv:2212.10496) • 階層・グラフ:RAPTOR(arXiv:2401.18059)/GraphRAG(arXiv:2404.16130、microsoft.github.io/graphrag)/LightRAG( arXiv:2410.05779)/HippoRAG 2(arXiv:2502.14802)/HopRAG(arXiv:2502.12442)/RAGSearch(arXiv:2604.09666) • Agentic:Self-RAG(ICLR 2024)/Corrective RAG(arXiv:2401.15884)/A-RAG(arXiv:2602.03442)/AgenticRAGTracer( Findings of ACL 2026) Advanced RAG 実践ガイド|新任テックリーダー向け 124
付録:主要出典② • 学習:RAFT(arXiv:2403.10131)/Search-R1(arXiv:2503.09516) • マルチモーダル・表:ColPali(arXiv:2407.01449)/T²-RAGBench(EACL 2026) • 長文・圧縮:Lost in the Middle(arXiv:2307.03172)/Long Context vs. RAG(arXiv:2501.01880)/LLMLingua-2( arXiv:2403.12968) • 評価:Ragas(arXiv:2309.15217)/ARES(arXiv:2311.09476)/ALCE(arXiv:2305.14627)/Q2D-Web(Perplexity)/MLPerf End-to-End RAG(MLCommons, 2026) • セキュリティ:PoisonedRAG(USENIX Security 2025) • 実務:Thoughtworks Technology Radar(RAG、Docling) • 本資料の補足で参照:Barnett et al., Seven Failure Points When Engineering a RAG System(CAIN 2024, arXiv:2401.05856) /Ruri: Japanese General Text Embeddings(arXiv:2409.07737)・cl-nagoya/ruri-v3 モデルカード/JMTEB Advanced RAG 実践ガイド|新任テックリーダー向け 125